一、语义判定为什么值得单独做
多数 Agent 运行时的判断并不复杂:这条请求应当路由到哪个处理队列、这次调用是否重试、现有证据是否支持某个结论(SemIf 仓库 README)。聊天模型能回答这些问题,代价是先生成一段文本,软件再把文本解析回结构化的取值,解析失败还要补上 JSON 修复与重试逻辑。SemIf 把这一环节单独做成接口:请求携带非结构化的状态(state)、运行时给出的问题与一组带描述的选项,模型直接给出各选项的概率,调用方不必再把模型输出解析回结构化取值,按概率分支。
在这种接口模式里,问题与选项随请求到达,新增一类判断不需要重新训练模型或改动服务。选项描述由调用方撰写,同一份状态换一组选项,就得到一组新的判断。调用方拿到的是概率分布,可以设置阈值,在概率接近时转向人工或其他处理路径。
Jev 是 TypeSafe 提供的托管服务,用于运行时定义的语义决策(SemIf README 说明)。TypeSafe 官方博客把这类模型称为 System One Model,称其以 RLCD(Reinforcement Learning for Calibrated Decisions)训练,输出类型化的概率值而非文本。该文给出的延迟为端到端 70 至 500 毫秒,对照前沿大模型的 3 至 329 秒,相差 40 至 200 倍;价格为输入每百万 token 0.042 美元,输出免费。官方还称该服务的输出带有校准过的概率与置信度,不会产生类型错误。上述数字与说法均出自官方博客自报。官方未公布统一的准确率指标,也未见第三方复现记录。
SemIf(原名 OpenJev)是独立开发者发布的开源项目,在 README 中自述为“Semantic ifs from open models, on a 3090 at home”。README 声明项目与 TypeSafe 无任何关联、未经其认可。项目复现的是运行时定义语义决策的接口模式,不涉及 Jev 未公开的模型与训练过程。其冻结基线包括 Qwen3-0.6B、MiniCPM5-2B、Qwen3.5-4B 与 Qwen3-Reranker-4B;除本地运行外,项目还提供仅需浏览器即可打开的 WebGPU 演示,模型以量化 GGUF 格式分发。
README 对显卡的要求是能够容纳 4B BF16 模型,复现环境为 Python 3.10+ 与 CUDA。按参数量推算,4B 的 BF16 权重约 8 GB,余量留给 KV cache,单张 24 GB 显存的 RTX 3090 因此够用,未经核验。
项目名称里的语义 if 指的就是这种调用形态:if 的条件不再由程序员写成表达式,而由运行时的问题与选项描述给出。
二、SemIf 的做法:一次前向读取选项 logits
Hugging Face 的文本分类文档给出的流程是,模型输出 logits,取 argmax 得到类别编号,再由 id2label 映射回标签,需要概率时对 logits 做 softmax。这是分类头(classification head)加 logits 打分的常规用法。SemIf 把同一模式推广到运行时给出的选项上:选项集合随请求到达,模型在提示中读到各选项的描述,代码读取已声明选项对应的 logits,softmax 之后即为各选项的概率。
长状态可以预填一次,再按多个条件分支求值。夹具、运行器、行级输出、模型 revision、提示与已知失败都随仓库提交,结果可逐条审计。与审计相关的说明分列在三个文档中,各有分工:Results(质量、速度、扰动、结论边界)、Method(冻结提示、指标、计时口径)、Reproduce(环境、固定命令、扰动、验证方式)。
生成式路径的对应机制是受约束解码。vLLM 把这类能力命名为 structured_outputs(旧名 guided_*),其中的 choice 表示输出恰为给定选项之一(vLLM 结构化输出文档)。两条路线都受选项集合约束,读取方式不同:受约束解码仍要生成 token,只是结果落在选项之内;SemIf 不生成 token,直接读取模型在选项位置上的概率分布。二者互为对照。
把答案读成概率,还免去了校验取值是否合法。生成式路径的取值可能超出选项、格式可能损坏,调用方需要校验与修复;概率路径的取值天然落在所声明的选项集合内,剩余的风险转移到概率是否可靠,校准与验证因此成为使用前提。
请求的形态如下(SemIf 仓库示例)。
1 | { |
返回的概率以所给选项为条件。README 建议在实际决策的工作负载上校准与验证这些概率,不要直接当作跨场景通用的置信度。state 也可以是 JSON 对象或数组,直接读取模式将其保留为结构化 JSON。
复现命令(README 快速入门)。
1 | python -m venv .venv |
1 | CUDA_VISIBLE_DEVICES=0 semif-score \ |
每条结果包含类型化选项分数、计时、确切的模型 revision 与提示哈希。记录 revision 与提示哈希使同一实验在权重或提示模板变动之后仍可被识别,复现时不必猜测当时的配置。当每一行使用完全相同的 state 时,改用 --mode shared,状态只预填一次,各判断条件并行求值。macOS arm64 另有 MLX 后端,支持直接读取、串行前缀复用与并行共享状态决策,安装时可选择依赖 mlx,命令中加 --backend mlx。
reranker 模式是项目保留的另一条路径。它把状态渲染为文档文本,用为检索排序训练的 Qwen3-Reranker-4B 给选项打分。项目把它作为对照基线,结论是这类模型在检索排序任务上与直接读取持平,在通用判断上弱于直接读取模式,对照表给出了具体数字。
三、实测数据与对照
直接读取与生成 JSON 的时间差
项目仓库提供了一段回放,把两条输出路径在同一时间轴上对齐:直接读取在一步之内给出全部类型化判断,生成式路径逐个 token 生成 JSON 数组。
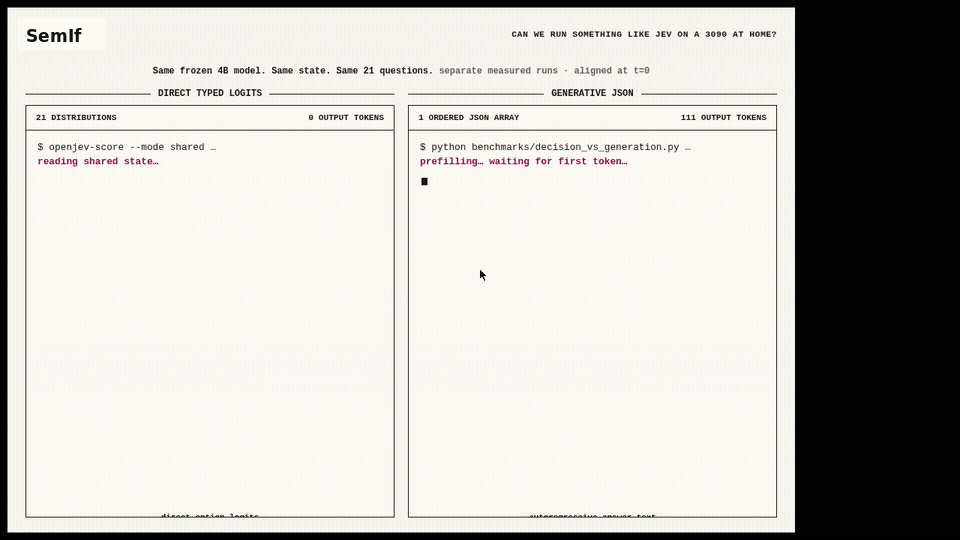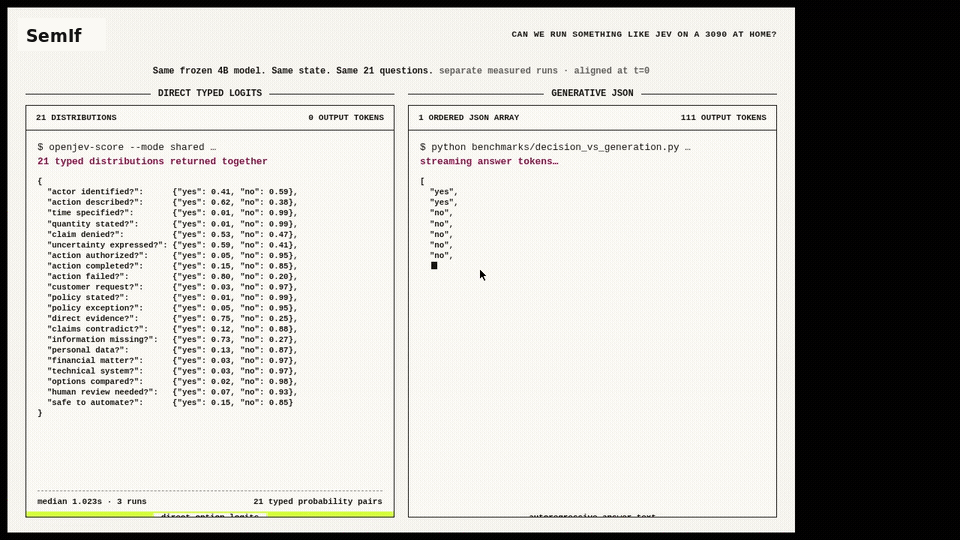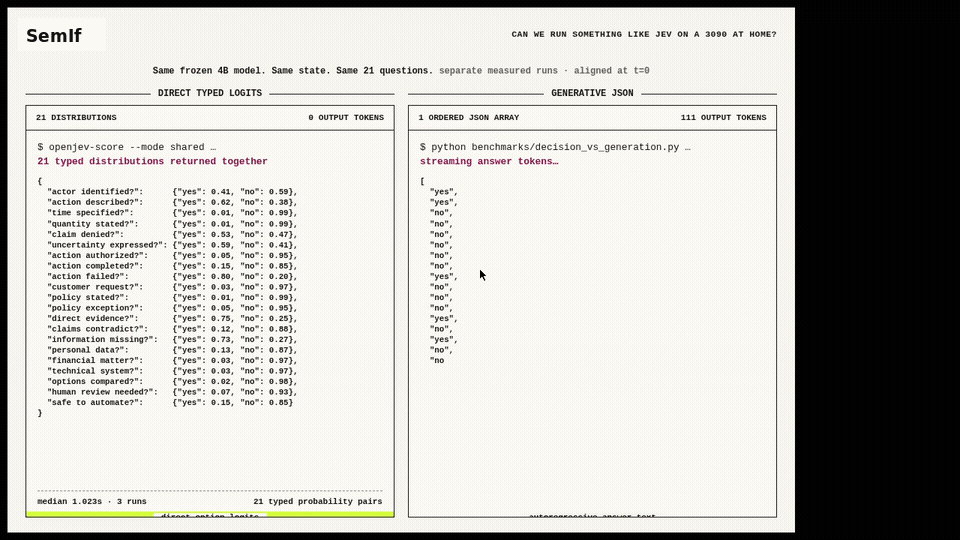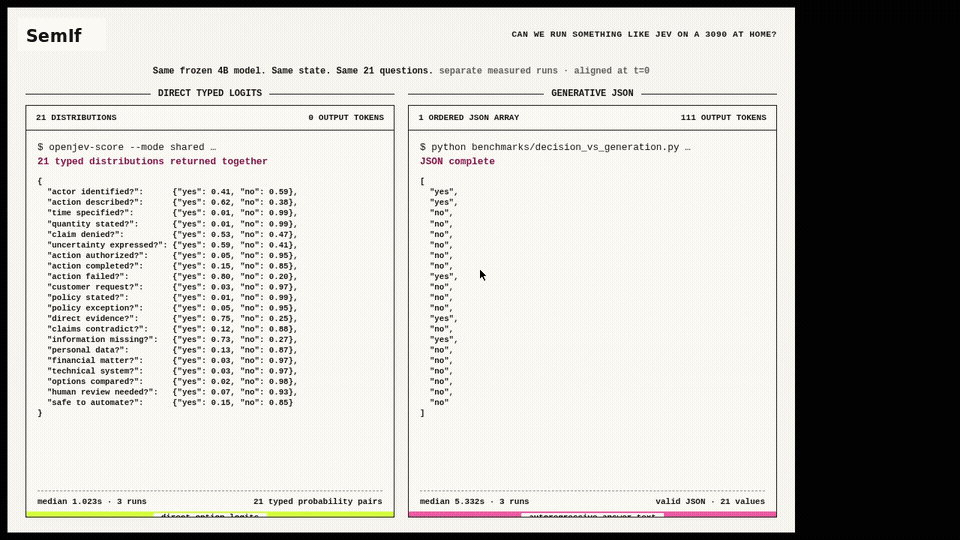
图 1 直接产出结构化决策与逐 token 生成 JSON 的重放对比(图源:SemIf 项目仓库)
速度实验在冻结的 Qwen3.5-4B 上进行,使用同一状态与 21 个二元判断,在单张 RTX 3090 上完成,各数值取三次测量的中位数(README 速度表,原始结果已提交至仓库)。
表 1:直接读取与生成 JSON 两条输出路径的耗时与输出对照(数据源:项目仓库 README)。
| 输出路径 | 耗时 | 输出 token 数 | 结果 |
|---|---|---|---|
| 直接读取类型化 logits(三次中位数) | 1.023 s | 0 | 21 组概率对 |
| 自回归生成紧凑 JSON 数组(三次中位数) | 5.332 s | 111 | 有序的 21 值数组 |
生成式路径只输出有序的 "yes" / "no" 取值,不含键名、置信度对象与解释。它的首 token 中位耗时为 0.489 秒,完成整个数组的时间是直接读取的 5.21 倍。三次生成的数组均有效且完全相同,其选择与直接读取的 argmax 在 21 个判断中有 18 个一致。这是系统层面的比较,不代表两种读取方式在语义上等价。
状态复用与 777 条决策的吞吐
在自撰的 37 状态 × 21 准则工作负载上(共 777 条决策),作者比较了三条执行路径与原生 reranker 的吞吐。该表未单独标注模型,按全篇口径为同一冻结模型与 BF16 执行。
表 2:三条执行路径与原生 reranker 在 777 条决策负载上的吞吐(数据源:项目仓库基准脚本与原始计时)。
| 执行路径 | 决策/秒 | 777 条决策耗时 |
|---|---|---|
| 全新直接评分 | 2.33 | 333.1 s |
| 串行前缀复用 | 10.75 | 72.3 s |
| 并行后缀 | 20.03 | 38.8 s |
| 原生 reranker | 1.86 | 417.3 s |
测量次数未见说明。
前缀复用与并行后缀都先把同一状态预填一次,再对不同判断条件求值,省去每个条件重新处理长状态的开销。37 状态 × 21 准则的构造接近 Agent 的真实负载:同一份长状态上要回答多个判断,只有问题不同。并行后缀的吞吐高于全新直接读取,原生 reranker 在同一负载上吞吐最低。作者声明快速复用路径属于实验性质:BF16 执行下,777 个 argmax 中有 5 至 6 个与全新评分不同。复用路径省下的时间有代价,对逐条结果的可复现性有要求的场合需要先核对差异。
与官方发布数字的对照
质量上,作者用同一套夹具比较模型规模,并在可对齐的公开案例上与 Jev 的发布记录对照。浏览器模型阶梯列出三种浏览器构件及其在 TypeSafe 子集上的一致率。
表 3:浏览器模型阶梯的质量对照(数据源:项目仓库 README)。
| 系统 | 浏览器构件 | 下载体积 | 自撰 balanced accuracy | 扰动后 balanced accuracy | TypeSafe 子集一致率 |
|---|---|---|---|---|---|
| Qwen3-0.6B | Q8_0 | 639 MB | 0.440 | 0.528 | 0.407 |
| MiniCPM5-2B | Q4_K_M | 1.56 GB | 0.686 | 0.693 | 0.637 |
| Qwen3.5-4B | Q4_K_M | 3.01 GB | 0.813 | 0.766 | 0.845 |
| Jev 公开发布值 | 闭源托管服务 | 无 | 无 | 无 | 0.883 |
README 脚注说明,分数在原生 BF16 下测得,浏览器构件使用量化 GGUF;Jev 一行为 TypeSafe 在同一 102 行子集上发布的数字。4B 在自撰工作负载上的表现随扰动下降,三档模型在两组指标上的排序一致。
表中各指标测的是不同侧面。自撰工作负载使用 balanced accuracy,让每个类别的判断同等计入,避免类别不均衡把结果抬高;扰动后一列在输入扰动后重测得到,用来观察判断是否依赖题面的表面写法。TypeSafe 子集一列与官方公开案例逐行核对,102 行上两者相差 0.038。
通用决策基线覆盖更宽的工作负载,直接 logits 与原生 reranker 在同一批行上对照。
表 4:与原生 reranker 及 Jev 发布值的一致率对照(数据源:项目仓库与官方公开记录)。
| 工作负载 | 行数 | 直接 logits(4B) | 原生 reranker(4B) | Jev 发布值 |
|---|---|---|---|---|
| 自撰决策,balanced accuracy | 144 | 0.813 | 0.625 | 无 |
| WANLI,balanced accuracy | 256 | 0.637 | 0.522 | 无 |
| TypeSafe 选定子集,modal agreement | 102(20 个案例) | 0.845 | 0.560 | 0.883 |
| Every judgment grid,accuracy | 36 | 0.806 | 0.694 | 无 |
| Every action firewall,组合 accuracy | 10 项动作 | 0.700 | 0.700 | 无 |
| Every code retrieval,Recall@1 | 6 个查询 | 1.000 | 1.000 | 无 |
| Every company knowledge,Recall@1 | 7 个查询 | 0.929 | 0.929 | 无 |
检索类任务上两条路线并列,判断与组合类任务上直接读取占优。WANLI 一行为外部自然语言推理数据集上的检查,两条路线都明显低于自撰工作负载,说明这类判断的难度更接近通用文本蕴含,与定制过的业务判定尚有距离。代码检索与公司知识两组 Recall@1 的查询数分别为 6 与 7,样本量小,只宜作为方向性证据。
这组对照的口径与官方汇总不同。SemIf 作者没有调用真实的 Jev 端点,0.883 取自 TypeSafe 的公开记录;比较覆盖的是能从公开材料对齐的 102 行,而非 TypeSafe 报告的 711 行汇总,该汇总的原始出处未见于公开材料,数值也未经独立核验。因此这一对照只能视为同一子集上的口径比较,不能读作两个系统的整体差距。两组速度实验同样限定在单张 3090 上完成,未涉及多卡与服务化部署。
四、与官方 Jev 的关系
SemIf 在 README 与仓库说明中声明独立性:Jev、TypeSafe 等名称与商标归各自所有者,也不声称达到官方服务的质量水平。质量对照不能替代对官方系统的评测,这一点在项目自己的结果文档中也有对应说明。
要理解被复现的接口,以官方文档为准。Jev 提供三类判断原语。Choice 从列表中选择一项,返回 choice、probabilities 与 confidence。Score 按给定标准为状态评分,返回 score、probabilities 与 confidence。Noul 判断一条陈述是否为真,返回 0 到 1 之间的连续值。公开文档中没有独立的 rating 或 yes/no 原语:评分类需求由 Score 承担,最接近是非判断的 Noul 也以连续值而非二值形式返回,需要离散结论时由调用方自行设阈值。
三类问题可以混在同一次 API 调用中,针对同一 state 的多个问题并行、彼此独立地求值,增加问题数量对响应时间的影响很小,问题之间也不共享上下文。官方建议只提出原子问题,原因也在于此:问题写得越接近一个可判定的命题,并行隔离求值的收益越充分。SemIf 对应的是 Choice 形态:请求给出带描述的选项,返回各选项的概率,语义上仍是从已声明选项中取一个。项目的速度与质量实验主要使用二元判断,输入示例则展示了多路路由形式的选项,两者在接口上属于同一机制。
五、局限与适用条件
无论使用官方服务还是本地开放模型,语义判定的能力边界由判断原语本身决定。TypeSafe 官方文档中版本号为 jev-1.13 的模型局限页逐项列出已知问题,这些条目同样界定复现项目的适用范围。模型按字面理解问题,范围、否定与隐含条件都不作引申;不做计算,计数不可靠,且误差随规模增长。日期按文本而非有序量读取,比较、间隔与时间窗不可靠。双重否定与复杂间接表达的回答可靠性下降。多跳推理会降低准确率。状态越长、无关内容越多,准确率越低。默认不把输入中的注入内容视为敌对。选项顺序会影响结果,模型偏向第一个选项。该模型未针对生成文本训练,用选项强迫它生成长文本既慢又差。
计算、计数与日期比较应留在代码里完成,模型只处理语义判断;官方文档给出的替代做法包括把日期拆成选项后由代码计算,计数按条目分别询问再求和,以及先用一个 Noul 判断内容是否相关。评分类的 Score 在精确量级上校准偏弱,不适合把分数当刻度使用;十六进制颜色、低级汇编与二进制这类内容的表现也弱于自然语言判断。条件与边界情况应在问题里写明确,可能被注入的内容需要显式声明并测试,选项顺序影响结果时通过重排核对一致性,需要长文本时改用正则或生成模型,或把有界抽取改写成 Choice。
SemIf 另有一项工程限定:两种模式切换时输入形态随之改变,直接模式读选项 logits,reranker 模式把状态渲染为文档。
这些边界决定了 SemIf 的适用场景:判断能用原子问题表达,候选选项可以枚举,单机显存足以容纳 4B BF16 模型。官方局限页没有给出基准数字,条目来自行为描述与工程建议,实际使用时仍应以自有工作负载上的校准结果为准。
