摘要
文本图像进入 OCR 之前必须先确定阅读方向,而方向错误不是精度损失,是整页不可用。本文把该问题建模为圆周上 24 个 15° 间隔的类别,并在其后接一级四方向残余偏移解析器:一阶段给出角度 ,图像按 正立化后,解析器在 5 个局部裁剪上判定残余偏移 ,输出 ,置信度达到 0.65 时才施加修正。把复核写成四选一而非倒置判定,使 90°/270° 一类错误也进入可修复范围,这是本文与常见"正立/倒置"复核路线的核心差别。两个阶段共用同一份清单:7,906 张训练原图、845 张验证原图与 1,337 张测试原图;测试集渲染 16 个固定角度,得到 21,392 个视角,置信区间由按原图分组的自助法给出,测试集只运行一次。交付配置达到 Acc@15 98.05%(95% CI 97.36–98.65)、severe90 1.21%、MAE 5.06°、宏 Acc@15 98.50%。唯一一组消融为"仅一阶段对交付配置":Acc@15 由 87.85% 升至 98.05%,severe90 由 11.31% 降至 1.21%,配对提升 10.20 pp(95% CI 8.80–11.61)。门槛判定为部分通过:宏 Acc@15 ≥95% 通过;severe90 1.21% 与 1% 的目标只差 0.21 pp,差距已收窄但仍未达标,最弱域是 scene_text 的 94.27%。因此本文所有结论都在"未通过 severe90 门槛"这一前提下成立。
1 引言
本节回答:为什么文本方向检测值得一个专门的输出空间,以及本文选择 24 类圆周分类加一级四方向复核的理由。
自 Hough 变换被用于检测图片中的直线以来 [1],文档倾斜估计一直是文档分析流水线的固定环节;今天主流 OCR 引擎仍把方向与倾斜检测(OSD)作为识别前的标准步骤 [5]。这一环节的特殊之处在于错误分布:方向判错不是让识别质量下降一个档次,而是让整页内容不可读;更进一步,这类错误并不连续分布,而是集中在几个离散对称上——一页纸横置 90° 与倒置 180° 是两种不同的失败,却同样让下游读不出字。于是问题不只是"估一个角度",而是"选一个能自然表达这些对称结构的输出空间"。
本文面向五个域:文档、票据、表格与表单、屏幕与幻灯片、场景文字。五域的成像差异很大:文档有版面结构,票据是密集细行,屏幕是合成字体,场景文字常是紧裁切的单词。因此训练按域赋权采样,评测按域、来源与角度切片分层报告,避免规模最大的域掩盖最弱的域。
方案分两级。一阶段把方向建模为圆周上 24 个 15° 间隔的类别:类空间封闭,边界只发生在相邻类之间,15° 量级的倾斜也有表达力。二阶段在一阶段之后:把图像按其预测角正立化,让一个小网络在局部裁剪上回答"残余偏移是 0°、90°、180° 还是 270°",置信度足够时才施加修正。只回答"是否倒置"的复核只能修复 180°,90° 与 270° 落在它的输出空间之外,而这两类错误正是 severe90 的主要来源;四选一让横置错误也成为可修复的,代价只是多认两个类别。深度模型已是这类判定的通用载体 [30],本文的着重点不在容量,而在把问题结构写进输出空间与流水线。
本文的贡献有四项:
- 标签层。 可复现的多路圆周融合流程(VLM 六格候选、OCR 行几何、投影剖面),在 10,088 张经许可审查的原图上产出连续基角,并记录逐样本离散度与拒识条件。
- 模型层。
OrientationNet的结构、圆周软标签目标与四向旋转测试增强,两个不同分辨率与容量的网络在 softmax 层集成。 - 推理层。 接在一阶段之后的四方向残余偏移解析器,把整数倍对称写成一个四选一决策,端到端成本只增加 30.1 ms。
- 评测协议。 固定 16 个角度(含三对跨类边界角)、按原图分组做自助法,并报告分域、分来源、角度切片、阈值敏感性与逐视角的修复/改坏转移。
本文同时如实记录未达成的部分:severe90 为 1.21%,与 1% 的目标只差 0.21 pp;最弱域 scene_text 的 Acc@15 为 94.27%。两项分别见 7.1 节与第 9 节。
2 相关工作
本节回答:已有的四类工作各自解决了什么,本文在哪些具体位置与它们不同。为避免把不同语料与协议下的数字并列,这里只做定性对照。
2.1 文档倾斜与阅读方向的经典估计
本节回答:传统方法用什么信号估方向,它们的前提在本文的场景里是否成立。
早期方法以像素统计与线检测为主。Hough 变换把直线检测转化为参数空间计数 [1],随后被用于估计扫描件的倾斜角;投影剖面沿候选方向积分,取使行投影对比度最大的角度 [2];Baird 系统分析了印刷体文档倾斜角的可估计性及其对识别的影响 [3];Le 等人把整页方向判定与倾斜角估计合为一个流程,针对二值文档图像给出可分级的判决 [4]。工程侧的代表是 OCR 引擎内置的 OSD,它在识别前给出四方向判决与粗倾斜 [5]。
这些思路在本文的标签层被复用:行投影对比度与文本行方向仍是我们估计连续基角的两路独立证据。差别在于问题设定。其一,输入不再是二值扫描页,而是五个域中占主导可读文字的区域,场景文字里可能只有几个单词。其二,输出不是连续倾斜角,而是圆周上 24 个离散类;连续角在本文是标签,不是模型的直接输出。其三,评测在 16 个固定角上进行,其中三对刻意压在类边界两侧,用来检验系统在类边界附近、而不是只在接近 0° 的微倾下的行为。这些差异决定了本文不能与上述工作报告的数字直接比较。
2.2 学习式方向判定
本节回答:学习式方法在方向问题上主要沿哪两条路线走,本文落在哪一侧。
一条路线诉诸等变性。群等变卷积把旋转、平移写进网络结构,使特征对变换保持可预测的响应 [28]。这对识别任务是优点,对方向判定却是反方向的优点:如果特征对旋转等变,网络就很难把"正立"与"横置"区分开。本文的取舍相反,网络刻意保持旋转敏感,只在末端做全局平均池化以聚合证据。
另一条路线把几何矫正写成可学习的回归目标。DocUNet 与 DewarpNet 用堆叠网络预测文档的形变场,把弯曲页面拉平 [13,14];它们的动机与本文一致——不要指望分类器在特征层面"吸收"几何畸变,而要把几何显式地放进流水线。差别在输出的粒度:它们预测稠密形变,本文预测一个四选一的整数倍偏移,并在正立化之后才让解析器看局部裁剪,因此解析器面对的是一个近似刚体的残余旋转问题。文档理解侧的预训练模型(如 LayoutLMv3 [15])把文本、版面与图像联合编码,其观察"版面结构本身携带方向线索"与本文的动机相通,但其容量与推理成本与本文的 CPU 实时约束不在同一档,因此这里只借用观察,不借用模型。
2.3 级联复核与选择性预测
本节回答:既然要"不确定就不改",为什么本文的门控不是拒识。
带拒识的选择性分类把"不确定就不答"形式化为一个可以优化覆盖率与风险的决策问题 [24]。这条线索与本文的门控形状相同、语义不同:本文的解析器不提供"拒答"选项,它提供的是"改判"。置信度不足时系统保留一阶段结果,因此输出永远是一个角度,失效方式是退化到一阶段精度,而不是给出空缺。这一差别让本文的指标可以直接沿用一阶段的度量,而不必引入覆盖率—风险曲线。
另一条相关线索是置信度校准。现代网络的 softmax 输出普遍过度自信 [25],因此把"置信度 ≥0.65"当作"错误率 ≤某阈值"的保证是不成立的。本文没有做温度缩放或后验校准,而是把阈值当作一个需要经验选择的工作点:在验证集上扫描,取性能平台的中部,并在 7.5 节报告平台宽度与两侧的陡降。这是对"置信度不可直接解释"这一事实的工程回应。
2.4 集成与测试时增强
本节回答:两个网络与四向旋转增强各自贡献了什么,为什么聚合方式不是细节。
深度集成用独立训练的多个网络做概率平均,是提高预测稳健性的经典手段 [22]。本文只用两个成员,原因不是效果,而是预算:CPU 实时约束把成员数限制在 2,因此互补性必须来自结构差异——两个网络的分辨率(192 px 与 224 px)与容量(46,192 与 217,842 参数)不同,而不是训练数据子集不同。
测试时增强的聚合方式会影响结果,简单平均并非总占优,已有工作系统比较过不同聚合策略 [23]。本文的旋转增强有一个额外约束:输出是 24 类圆周上的分布,把输入旋转 后,正确做法不是重新训练一个旋转后的分类器,而是把输出概率沿类别轴滚动 格再平均。这一步要求类别空间是 24 阶循环群,也是本文选择 24 类而不是 4 类的附带好处:滚动量在整数倍旋转下是良定义的。
3 问题定义与评价协议
本节回答:如何把"方向"写成可优化、可度量、可复现的对象。
3.1 圆周角度约定
本节回答:角度、类别与误差三者如何定义,边界在哪里。
角度 定义为把图像顺时针旋转多少度后文字回到从左到右的正常阅读方向,取值落在 上,共 24 个类,类中心 。真值 是标签阶段给出的连续基角;评测时把原图再旋转 度构成一个视角,该视角的真值为 。
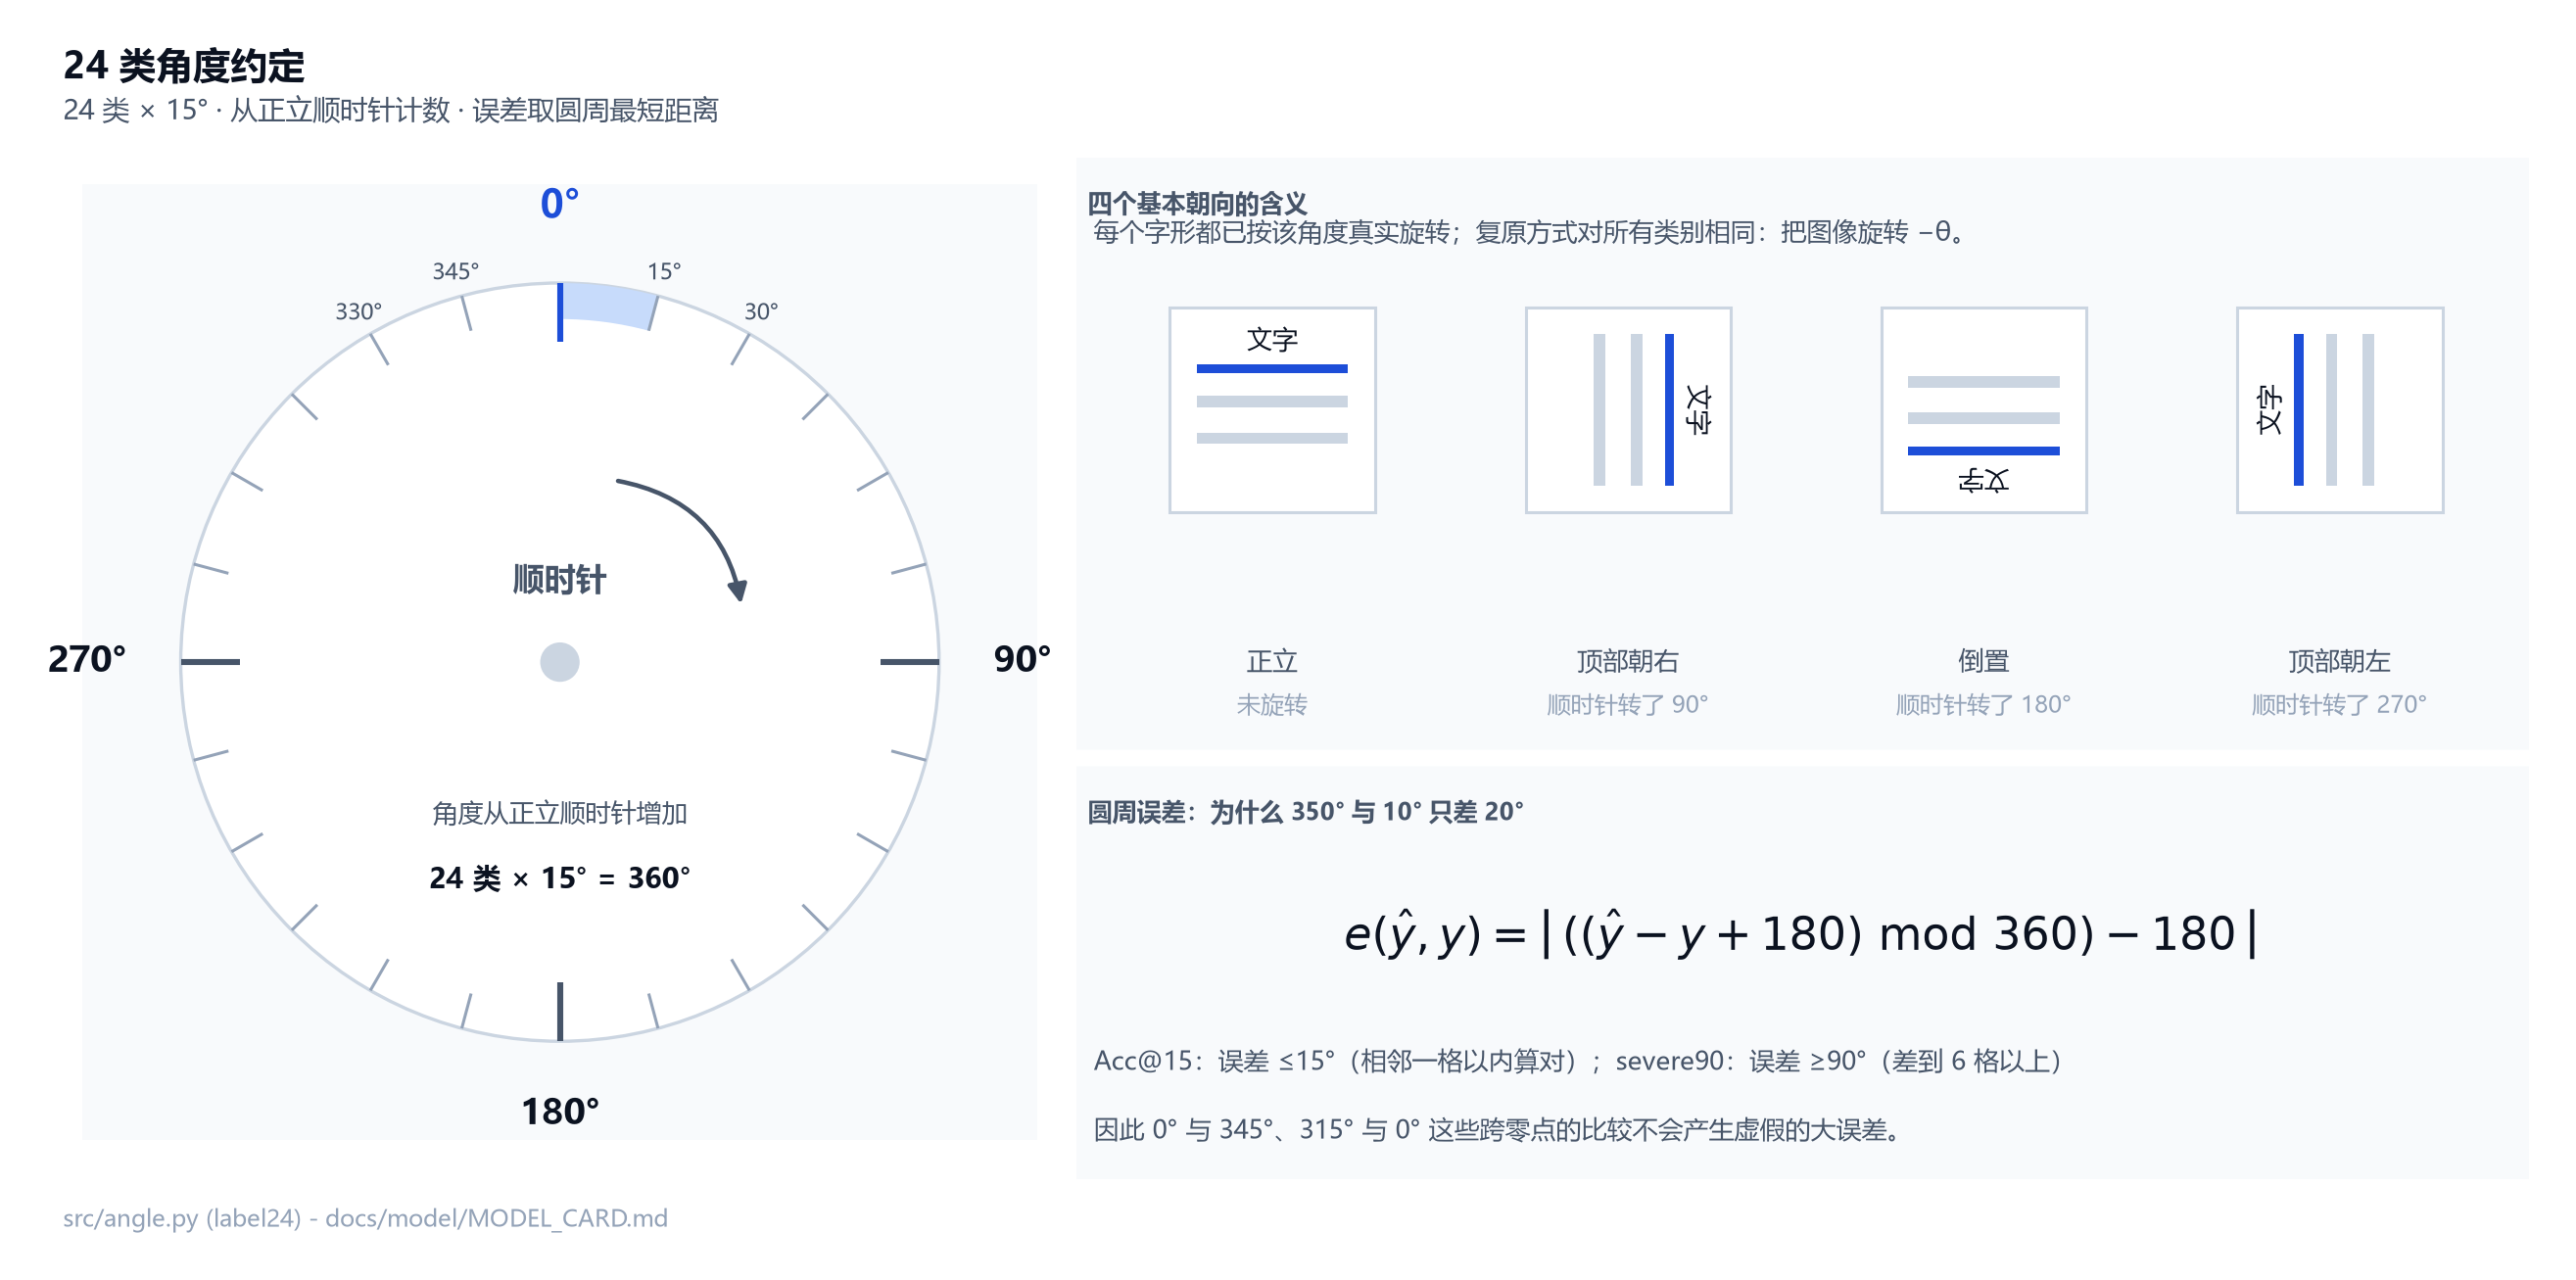
图 1 标签定义为文本相对正常阅读方向被顺时针旋转的角度,24 个类别以 15° 等分圆周:0° 正立、90° 顶部朝右、180° 倒置、270° 顶部朝左。误差取圆周最短距离,因此 350° 与 10° 只差 20°,而不是 340°。Acc@15 允许一格误差,severe90 统计误差 ≥90° 的视角比例。
读图时先固定两件事:类中心是 15° 的整数倍,类边界落在 上,所以"跨边界"与"跨 90°"是两种不同的错误——前者靠一阶段的细粒度能力,后者靠二阶段的整数倍修正。误差取圆周距离
它把 358° 与 2° 视为相距 4°。圆周量的均值、距离与分布需要专门的统计工具 [27],本文凡涉及角度平均(标签融合、误差汇总)都按单位向量处理,而不是对角度数值做算术平均。
3.2 指标
本节回答:用哪几个数描述系统,它们各自防的是什么失效。
换口径是让数字变好看最省事的办法,因此先把指标写死。表 1 给出本文使用的五个指标,全部在测试集上报告。
表 1 评价指标定义
| 指标 | 定义 | 在本文中的角色 |
|---|---|---|
| Acc@7.5 | 圆周误差 ≤ 7.5° 的视角比例 | 严格容差下的精度读数 |
| Acc@15 | 圆周误差 ≤ 15° 的视角比例 | 主指标,与 24 类网格的半个类宽一致 |
| severe90 | 圆周误差 ≥ 90° 的视角比例 | 灾难性错误率,验收门槛 |
| MAE | 圆周绝对误差的算术均值 | 误差的连续大小 |
| 宏 Acc@15 | 五域 Acc@15 的算术平均 | 防止大域掩盖弱域 |
读表要点:Acc@15 是主指标,severe90 是门槛指标,宏 Acc@15 是为域间公平引入的辅助指标。三者分工明确——在 7.1 节的判定里,主指标与宏平均过线,门槛指标未过线,这个组合本身就是结论。除比例之外,本文还报告 off90 与 off180:误差正好等于 90° 与 180° 的视角计数。它们不是比例,而是机制证据——整数倍对称错误占总错误的比例,正是判断四方向复核是否有针对性的依据。
3.3 评测协议与不确定性
本节回答:一次评测包含哪些视角、区间怎么算、以及为什么这些数字不能被反复挑选。
协议有三条硬约束。第一,测试集只开一次:检查点、集成成员、阈值与门控规则全部在验证集上固定之后,才在测试集上运行一次。第二,旋转在划分之后施加:先在原图层面切分,再对每张测试原图施加 16 个固定角度——0°、7.4°、7.6°、15°、22.4°、22.6°、45°、75°、90°、135°、180°、225°、270°、315°、352.4°、352.6°;其中 7.4°/7.6°、22.4°/22.6°、352.4°/352.6° 三对刻意压在类边界两侧。第三,区间按原图分组:同一张原图的 16 个视角高度相关,把它们当独立样本会低估方差,因此自助法以原图为重采样单元 [26],2,000 次重采样,取 2.5/97.5 百分位,种子 20261024。
配对比较沿用同一分组:两个配置在同一个重采样批次里相减,因此区间反映的是"同一批原图上的差",而不是两个独立区间的重叠程度。这一做法在 §7.1 的两组数字里都用到了。
4 数据
本节回答:语料来自哪里、标签怎么得到、如何保证训练与评测不重叠、训练如何配比。
4.1 语料与划分
本节回答:总共多少数据、怎么分、两个阶段各看其中哪一部分。
系统只用一个语料:data/manifest_stage2.csv。两个一阶段网络与四方向解析器都在它的 train 划分上训练,全部评测使用它的 test 划分;因此下文任何"训练了 7,906 张"的说法都指同一批原图,不存在两套数据。
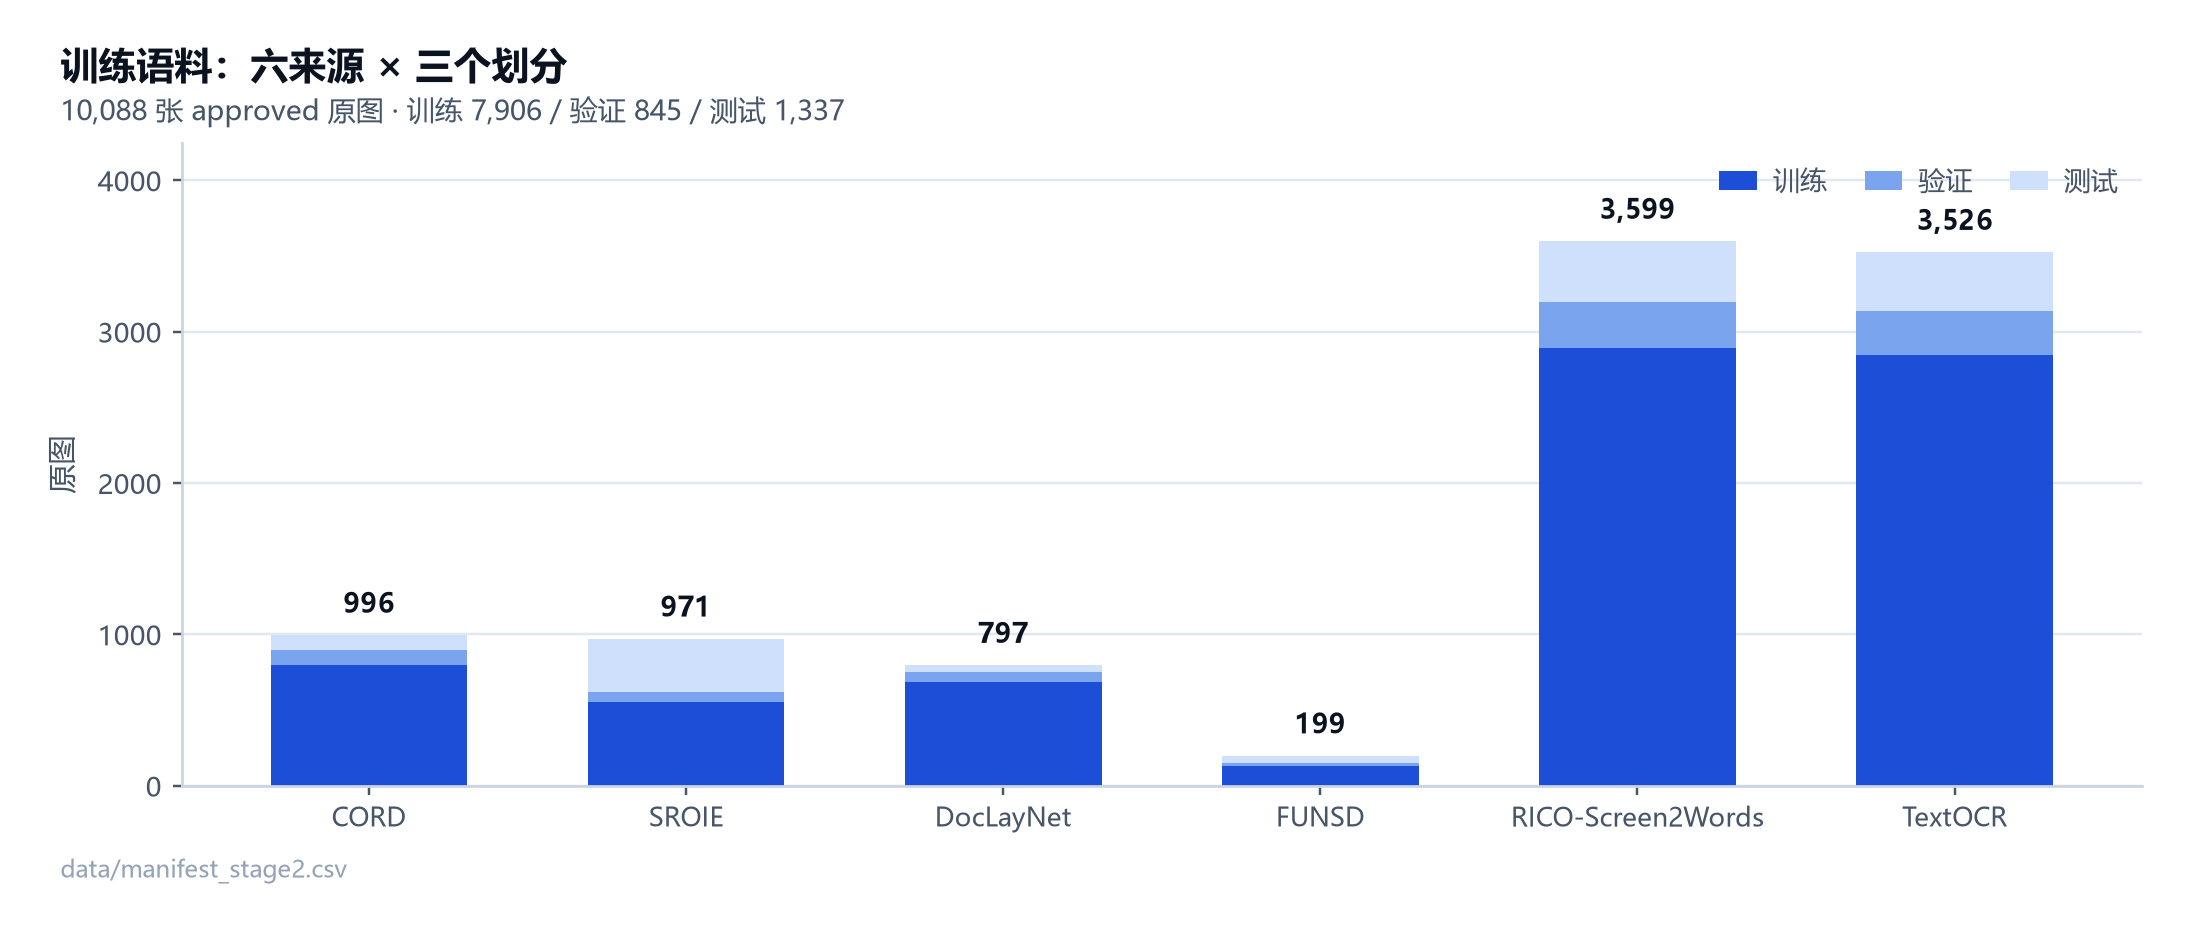
图 2 10,088 张 approved 原图覆盖六个公开来源,按来源堆叠 train/val/test。两个一阶段网络与四方向解析器都只在 train 划分(7,906 张)上训练,全部评测用 test 划分(1,337 张)的 16 个固定角度,划分在原图层面完成且两两不共享像素哈希。RICO 与 TextOCR 合计占七成,因此小来源(FUNSD 199 张、DocLayNet 797 张)的分域数字要配合区间阅读。
读图时看柱高与颜色的分工:柱高是来源规模,颜色是划分比例。六来源的测试占比并不相同,测试原图最少的 DocLayNet 与 FUNSD(48 张与 50 张)直接决定了它们分域区间的宽度;RICO 与 TextOCR 合计占七成,因此小来源的波动不能被总量掩盖。
表 2 语料构成
| 语料 | 用途 | approved | train | val | test |
|---|---|---|---|---|---|
manifest_stage2.csv | 两个一阶段网络 + 四方向解析器 + 全部评测 | 10,088 | 7,906 | 845 | 1,337 |
语料由六个公开来源构成,映射到五个域:CORD 996 张(train 796 / val 100 / test 100)与 SROIE 971 张(552 / 68 / 351)为票据,分别来自票据字段解析 [7] 与扫描票据竞赛数据 [8];DocLayNet 797 张(685 / 64 / 48)为文档,来自版面分割标注数据 [9];FUNSD 199 张(131 / 18 / 50)为表格与表单,来自噪声扫描件上的表单理解数据 [6];RICO-Screen2Words 3,599 张(2,895 / 304 / 400)为屏幕与幻灯片,来自移动界面数据集 [10] 及其界面摘要标注 [12];TextOCR 3,526 张(2,847 / 291 / 388)为场景文字,来自任意形状场景文字数据 [11]。另有 83 张因多路标签不一致或质量审计被留为 status=review,保留在清单中供审计追溯,但从不参与训练与评测。
两个阶段吃同一份语料,但看的东西不同:一阶段看整图缩放到 192 px 或 224 px,二阶段看正立化后的局部裁剪。同一个 train 划分在两种输入形态下都被用到,真正的差别在采样预算——每个一阶段网络训练 30 轮 × 54,000 个采样视图 = 1.62M 个样本,相当于每张训练原图被看约 205 遍;解析器是 14 轮 × 12,000 个视图。这个预算与被评分的视角数无关,评测始终只跑一次。
4.2 标签构建
本节回答:15° 分辨率的标签从哪来,噪声有多大,如何披露。
分类器在 15° 网格上预测,标签必须达到同样的分辨率;而 0/90/180/270 的基数标签只能回答"哪边朝上",会在 ±7.5° 的类边界上悄悄封顶精度。因此发布的标签是连续基角,由三路独立信号融合得到:VLM 六格候选对照图(把原图旋转到中心角 −30°…+45° 的六个候选格,由模型选最正立的一格)、OCR 文本行几何(检测框长边角度按长度加权做圆周平均,与经典引擎的版面信号同源 [5])、投影剖面(使行投影对比度最大的旋转角,0.1° 精修)。
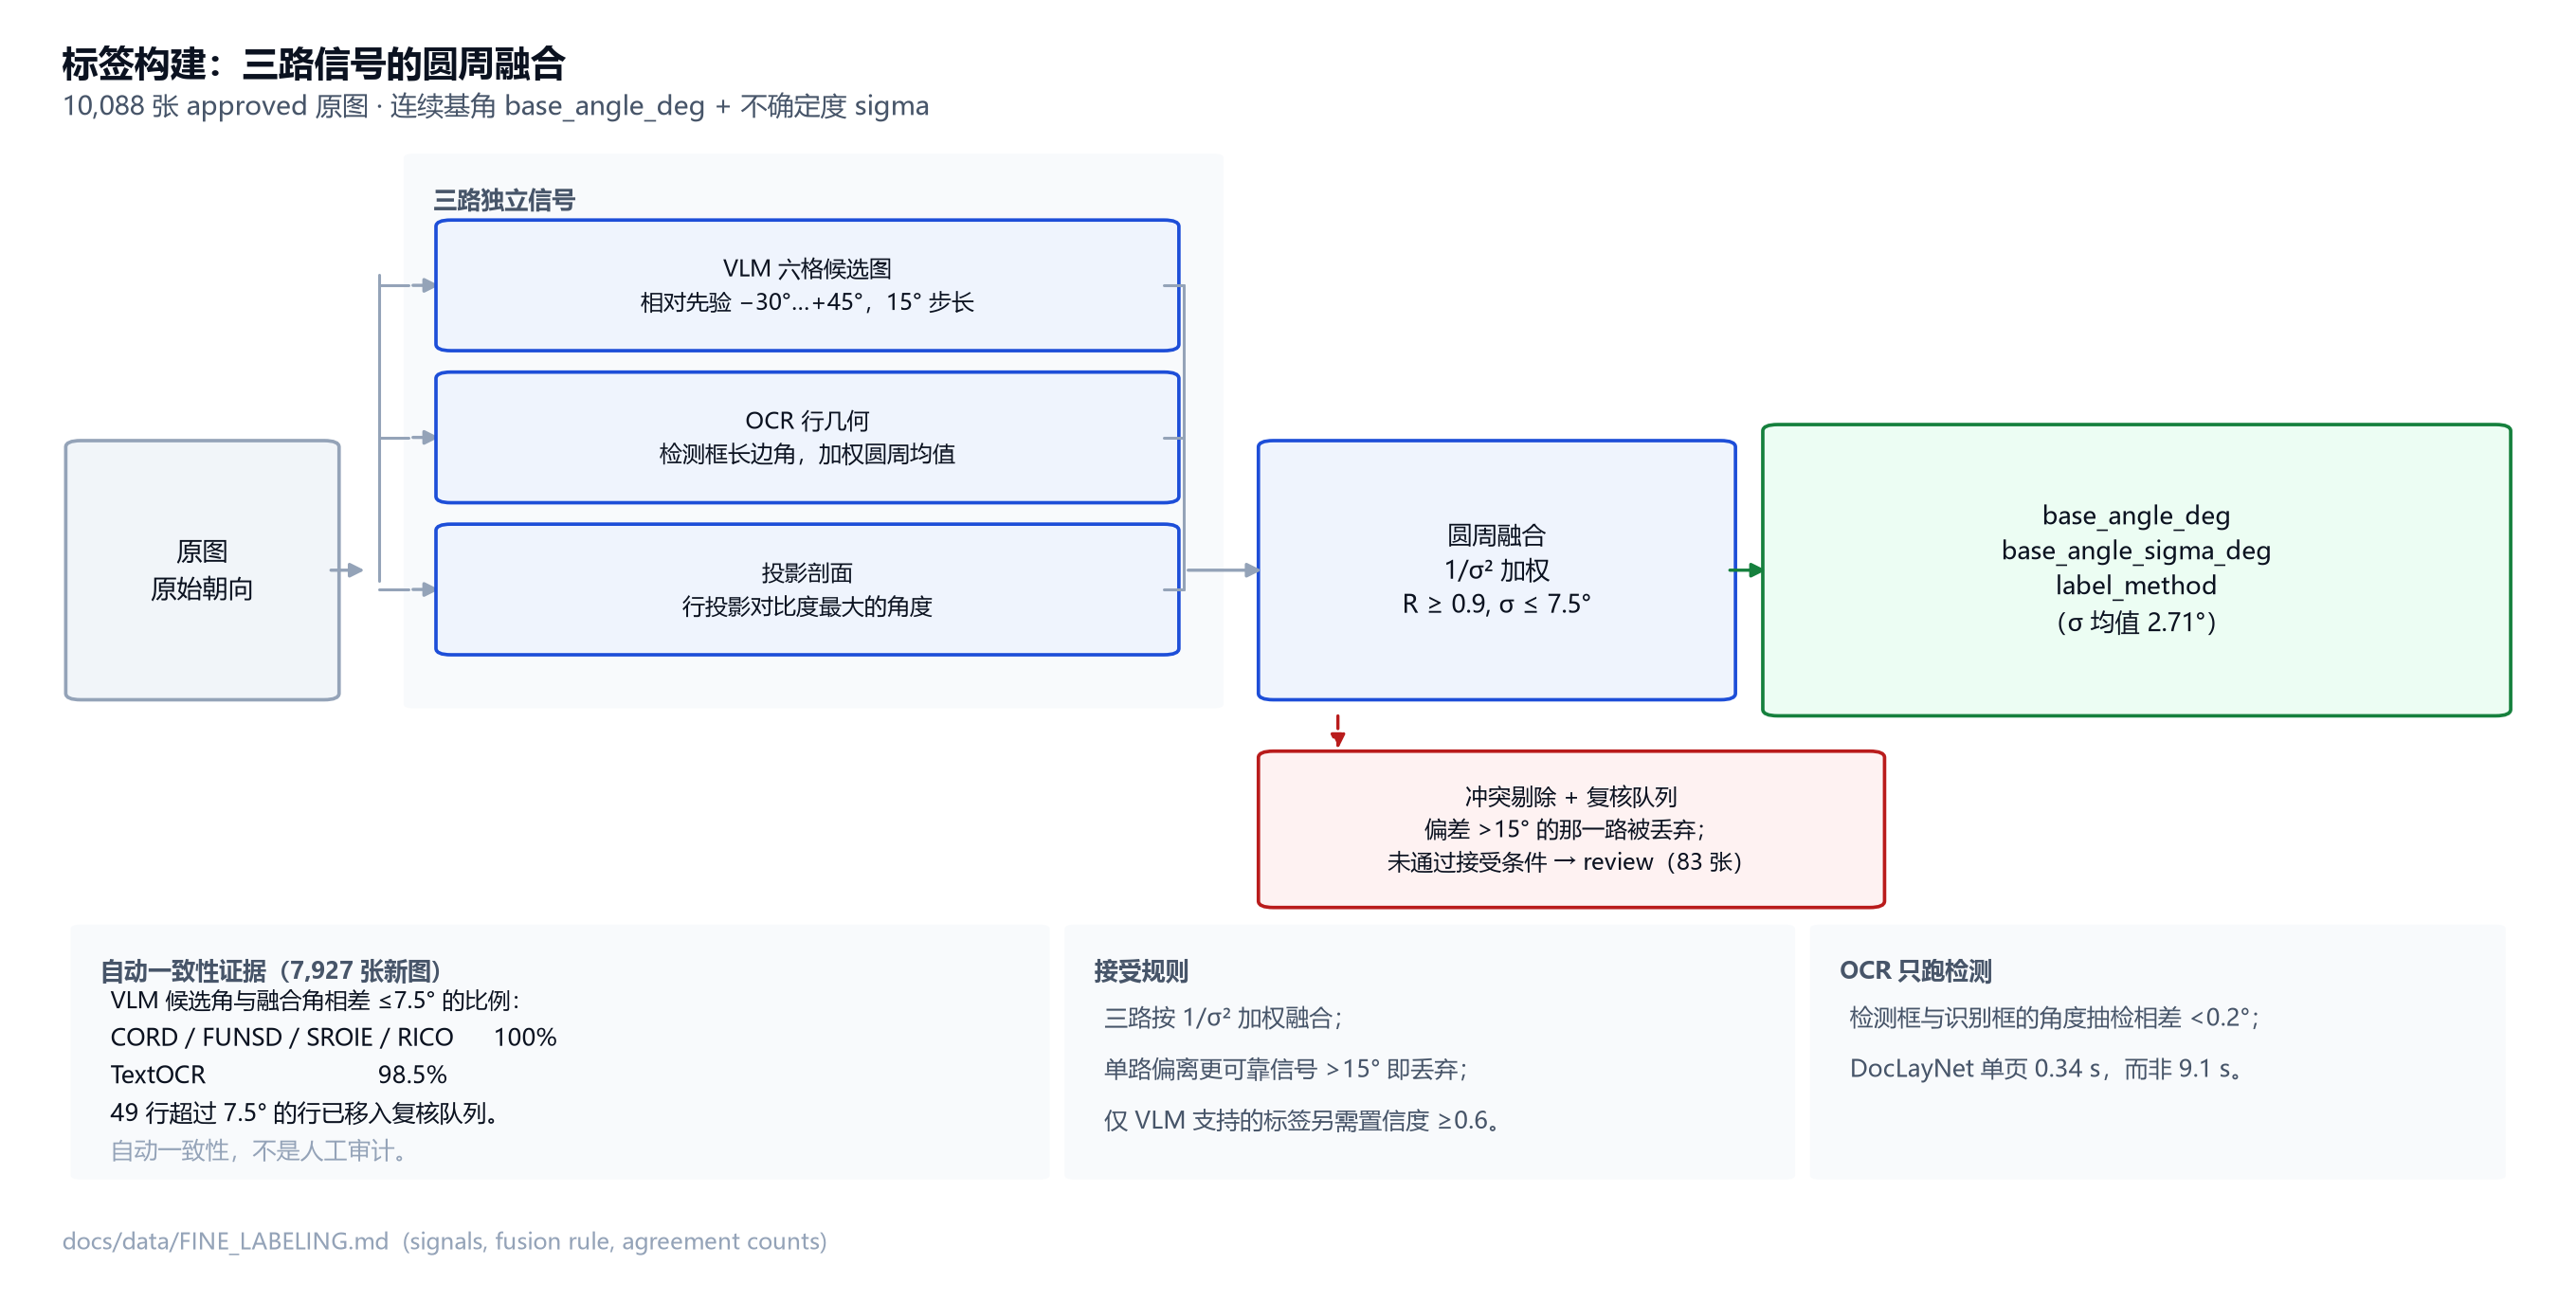
图 3 基角由 VLM 六格候选、OCR 行几何与投影剖面三路独立信号按 1/σ² 权重圆周融合得到。与更可靠信号相差超过 15° 的一路被丢弃,未通过接受条件的样本进入复核队列。在 7,927 张新图上,VLM 候选角与融合结果相差不超过 7.5° 的比例为 CORD/FUNSD/SROIE/RICO 100%、TextOCR 98.5%,这是自动一致性而非人工审计。
读图时看的是融合位置而不是三路各自的分工:信号先转成单位向量、按 加权,任何一路与更可靠信号相差超过 15° 就被丢弃而不是平均;接受条件同时要求一致性 与不确定度 ,否则置为 status=review。最终标签因此是"多路一致时的判决",而不是三路平均出来的折中值。
三路的使用并不均衡,这是成本与交叉校验的折中:10,088 张 approved 原图中有 7,848 张用到 VLM、7,007 张用到 OCR 行几何、1,136 张用到投影剖面;单路标签 4,673 张,两路或三路一致 5,415 张,其中仅投影一路的 74 张没有第二路交叉校验;逐样本离散度的均值为 2.71°。VLM 侧的平均自报置信度 0.98,候选角与最终融合角相差不超过 7.5° 的比例在 CORD、FUNSD、SROIE、RICO 上均为 100%,在 TextOCR 上为 98.5%。
必须说清的是,以上都是自动一致性,不是人工审计。替代证据是受控旋转审计:取 300 张 approved 原图额外施加一个已知随机角,比较恢复角与「基标签 + 施加旋转」的差,得到 MAE 12.24°、中位数 0.63°、p90 6.49°、误差 ≤15° 的比例 91.0%,其中 17 张在额外旋转后无可用信号(按 180° 失败计),去掉这些样本后 MAE 为 2.16°。这条审计衡量的是旋转残差精度,不是基标签的绝对正确率,细节见标签文档。
提示词只要求模型在候选格中选一格,不要求它直接给出角度——15° 分辨率来自候选网格与精确的合成旋转,而不是模型的量角能力。发布语料所用的六格对照图协议,系统提示词如下(取自 src/fine_label.py,与协议文档的约定一致):
1 | 你是文字朝向数据标注器。输入是一张由 6 个候选旋转组成的对照图,每格左上角有编号。 |
调用时用户消息只追加一句"请只返回 JSON:哪一格文字最正立?",图片以 base64 JPEG 随消息发送,temperature=0、max_tokens=120,并在请求体里关闭思考。端点只需兼容 OpenAI 的 chat.completions 图像消息格式,密钥从环境变量读取而不是写进配置;失败时模型被要求返回 mixed/unreadable 而不是猜测,这些样本进入 status=review,从不进入训练。
4.3 泄漏控制
本节回答:凭什么说训练集与评测集没有重叠,这条保证如何被持续检验。
划分单元是原图与源文档,而不是视角。group_id 由「来源:划分:文档名」构成,入库时给文件名加划分前缀以消除跨来源的偶然重名;训练器(validate_leakage)拒绝任何跨划分的 group 或像素哈希。字节级与像素级重复用解码像素的 SHA-256 去重;上游自带官方划分的一律沿用,其余用稳定哈希切分。
一阶段的训练原图与评测集之间共享的像素哈希数为 0。这条断言不是声明,而是产物级检查:src/extract_metrics.py 在每次生成 METRICS.md 时重新计算并写入交叉核对表,任何一侧清单变动都会让它立刻失败。同一脚本还核对清单内部"没有原图或像素跨划分"(0 处违规),以及测试视角数恰等于原图数 × 16。
测试侧的隔离还依赖使用纪律:测试集在检查点、集成成员、阈值与规则全部于验证集固定之后才被打开,此后只跑一次。这一条无法从文件层面验证,只能由产物时间戳与本文的记录背书。
4.4 域采样
本节回答:训练分布与语料分布为何不同,代价是什么。
训练不按语料自然比例采样,而按五个域赋权:documents 0.35、tables_forms 0.20、receipts 0.15、screens_slides 0.15、scene_text 0.15;域内先按来源均匀、再按原图均匀抽取,避免某个大来源主导整个域。
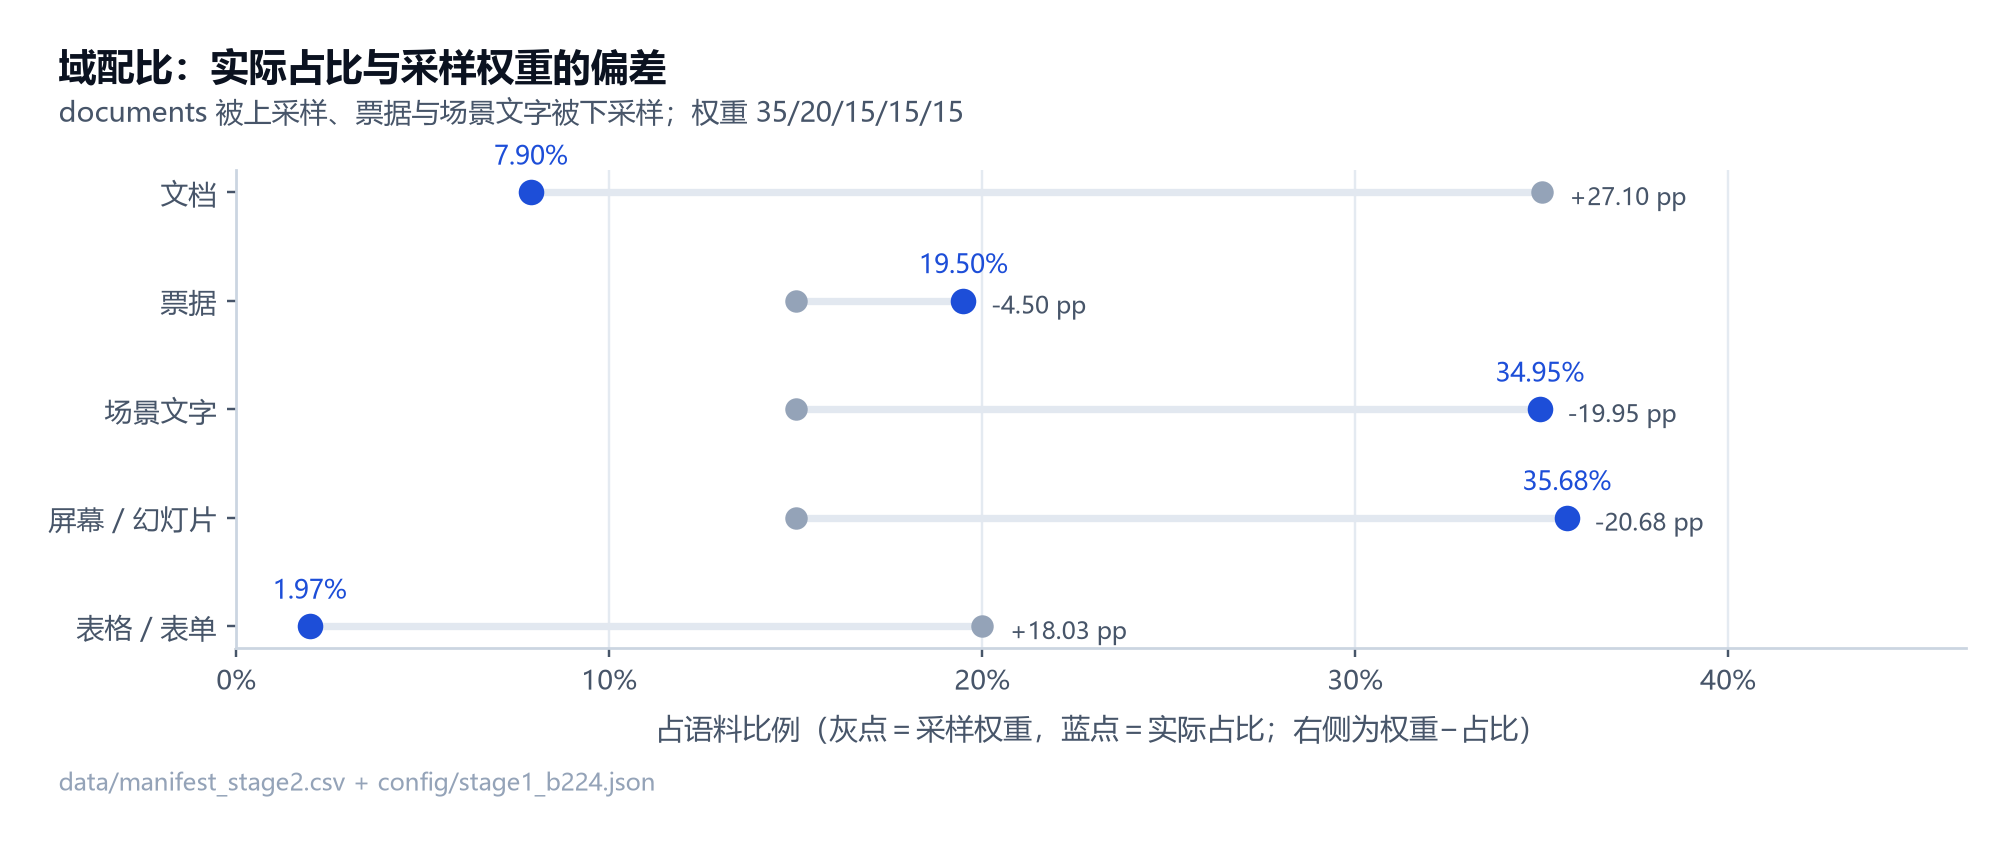
图 4 训练按 35/20/15/15/15 采样五个域,而语料的自然分布以票据与场景文字为主。灰点是采样权重、蓝点是实际占比,右侧数值为「权重 − 占比」,正数表示上采样:documents 因此被上采样约 27 pp,票据与场景文字各被下采样约 4.5 与 20 pp,避免最大的域淹没最弱的域。
读图时要比较两根点之间的距离而不是绝对值:实际占比与采样权重的差就是过采样或欠采样的幅度,documents 被明显上采样、屏幕与场景文字被欠采样;因此分域指标的方差并不相同,样本最少的域也不会因为上采样就变稳。域不全是硬停止条件:五域任一缺失时训练不启动,不允许静默替换或重新归一化——这一条在跨域部署时比在本报告的单语料设定下更容易触发。
5 方法
本节回答:模型如何把图像映射到圆周类别、两级如何衔接、训练如何设定。
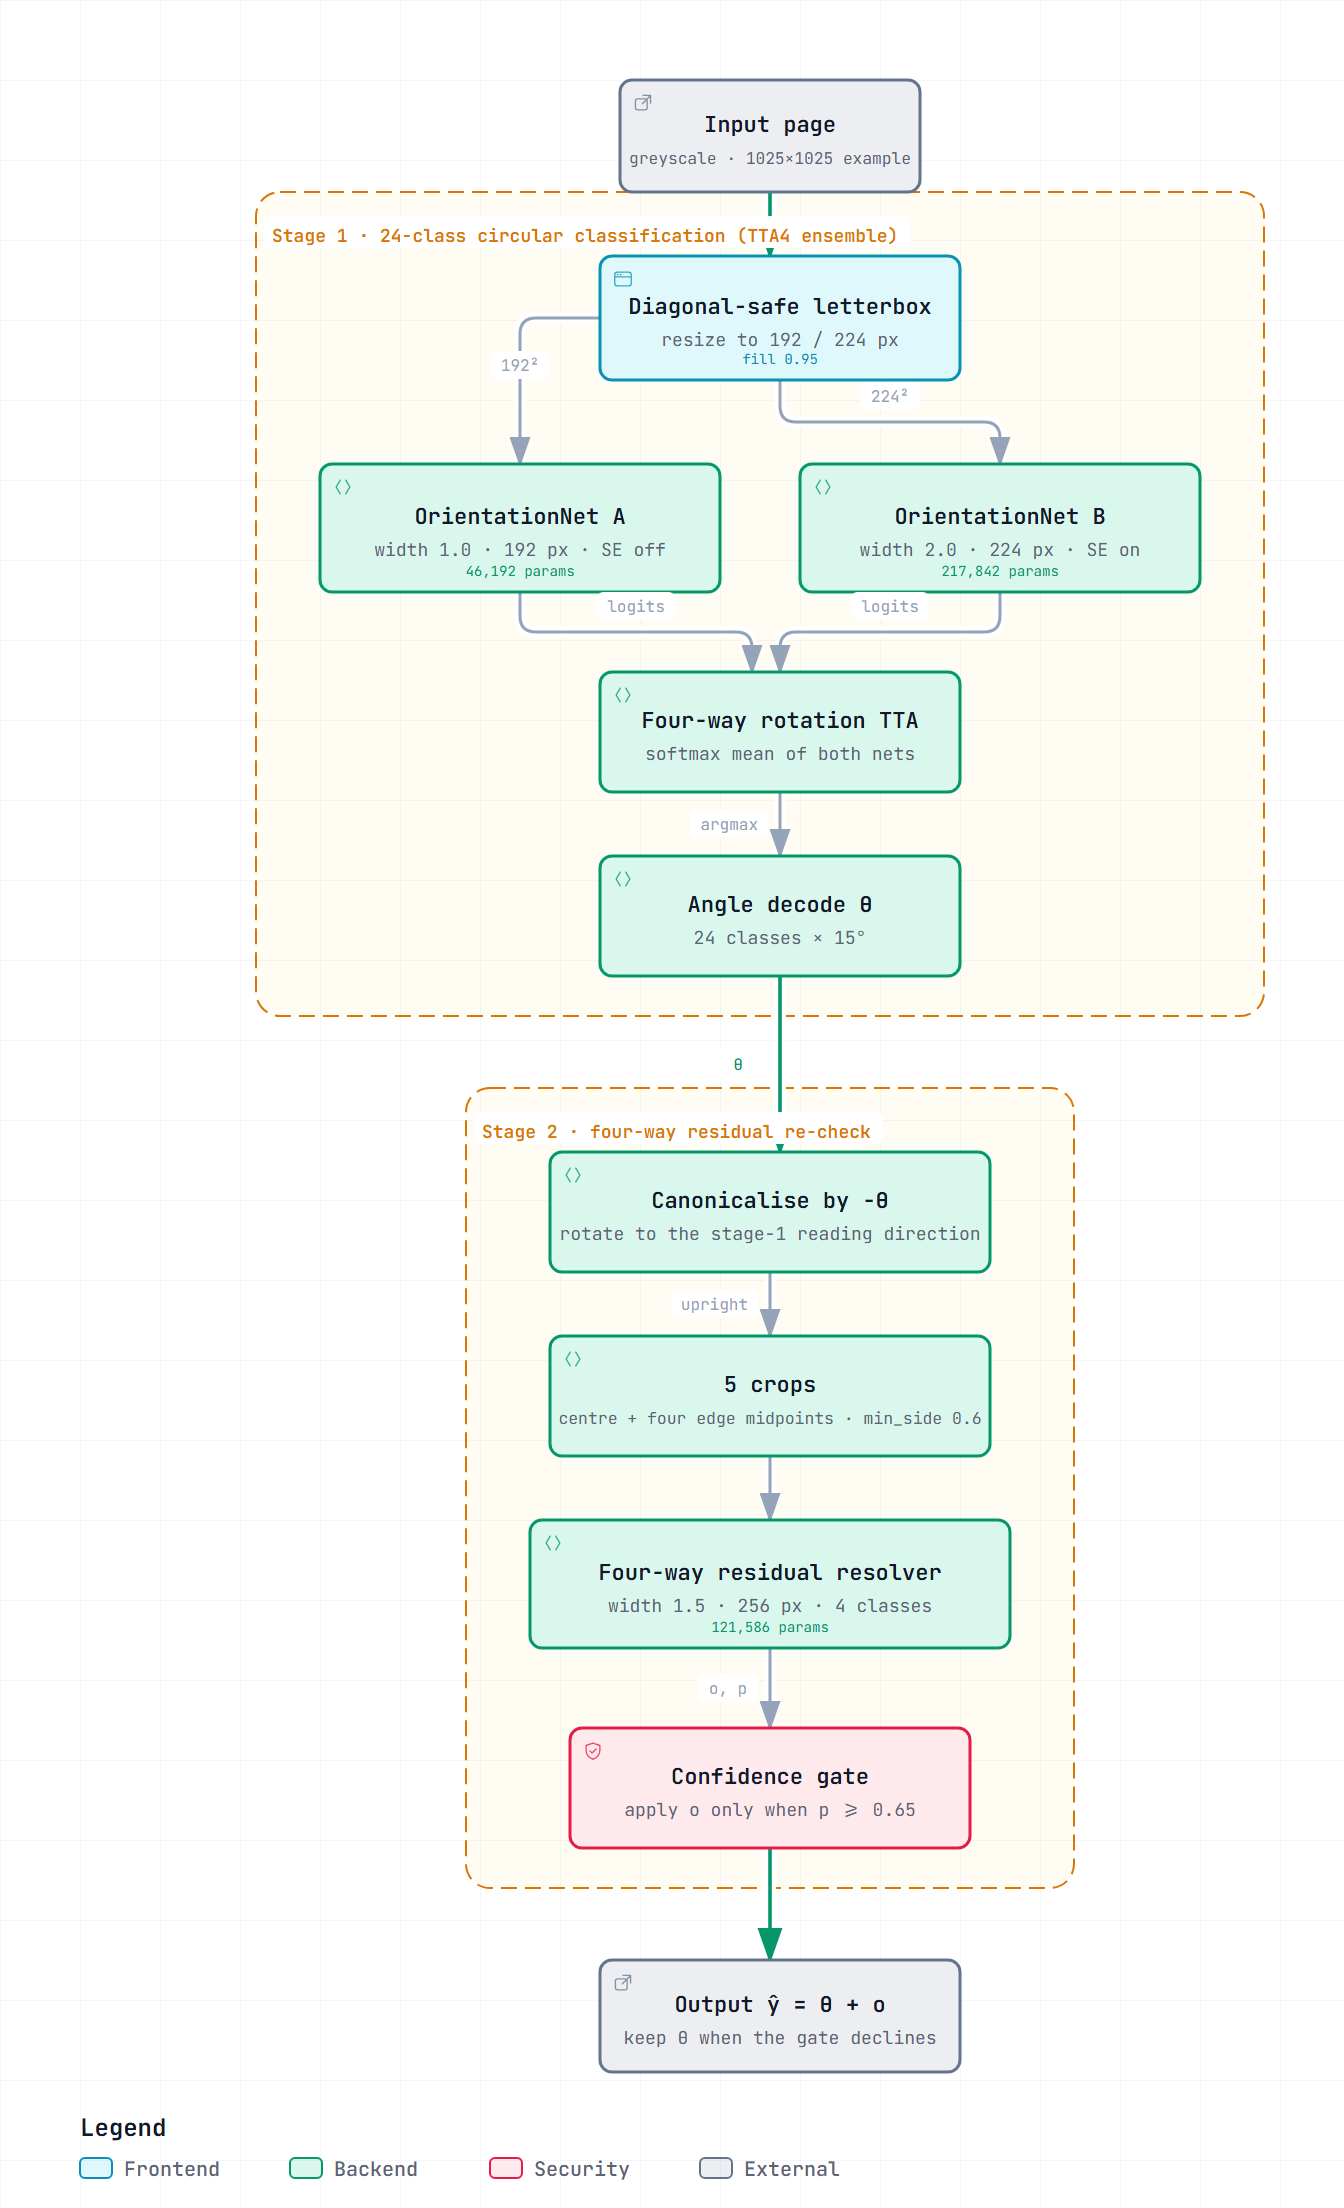
图 5 整图自上而下就是一次推理:页面先过对角线安全 letterbox,按 192 px 与 224 px 分别送入两个 OrientationNet,四向旋转 TTA 后 softmax 平均、解出 24 类角度 θ;图像按 −θ 正立化,取中心与四边中点共 5 个裁剪,由四方向残差解析器给出偏移 o 与置信度,达到 0.65 才施加,输出 ŷ = θ + o。虚线框是两个阶段的职责边界:一阶段负责 15° 精度的圆周定位,二阶段只在四个整数倍上复核,因此无法把 15° 量级的判断改坏。参数标注在各自节点上,合计 385,620。
同一张图另有可交互版本(离线可开,支持明暗主题与逐条路径高亮,图为英文标注):figures/model_framework.en.html。
5.1 24 类圆周参数化
本节回答:为什么是 24 个类,而不是 4 个类或连续回归。
四个类无法表达 15° 量级的倾斜,而连续回归必须显式处理周期性,并且在类边界附近容易抖动。24 类取两者之间:类宽 15°,Acc@15 恰好允许一格误差,类空间封闭因此不存在"超界"的预测,而相邻类之间仍可借助软目标平滑过渡。对真值 构造圆周软标签
其中 由 换算。这与标签平滑 [21] 是同一类思想——把硬目标换成邻域内的软分布——只是邻域定义在圆周上而不是索引轴上,因此不存在"最后一类与第一类不相邻"的边界效应。
5.2 一阶段网络
本节回答:网络为什么这样设计,两个规模的差别在哪。
一阶段是 24 类的 OrientationNet:单通道灰度输入,一次步长 2 的普通卷积接 6 个深度可分离卷积块(每块后接 SE 门控与批归一化),末端全局平均池化接 24 类线性头;224 px 那一档另有 sin/cos 辅助头。
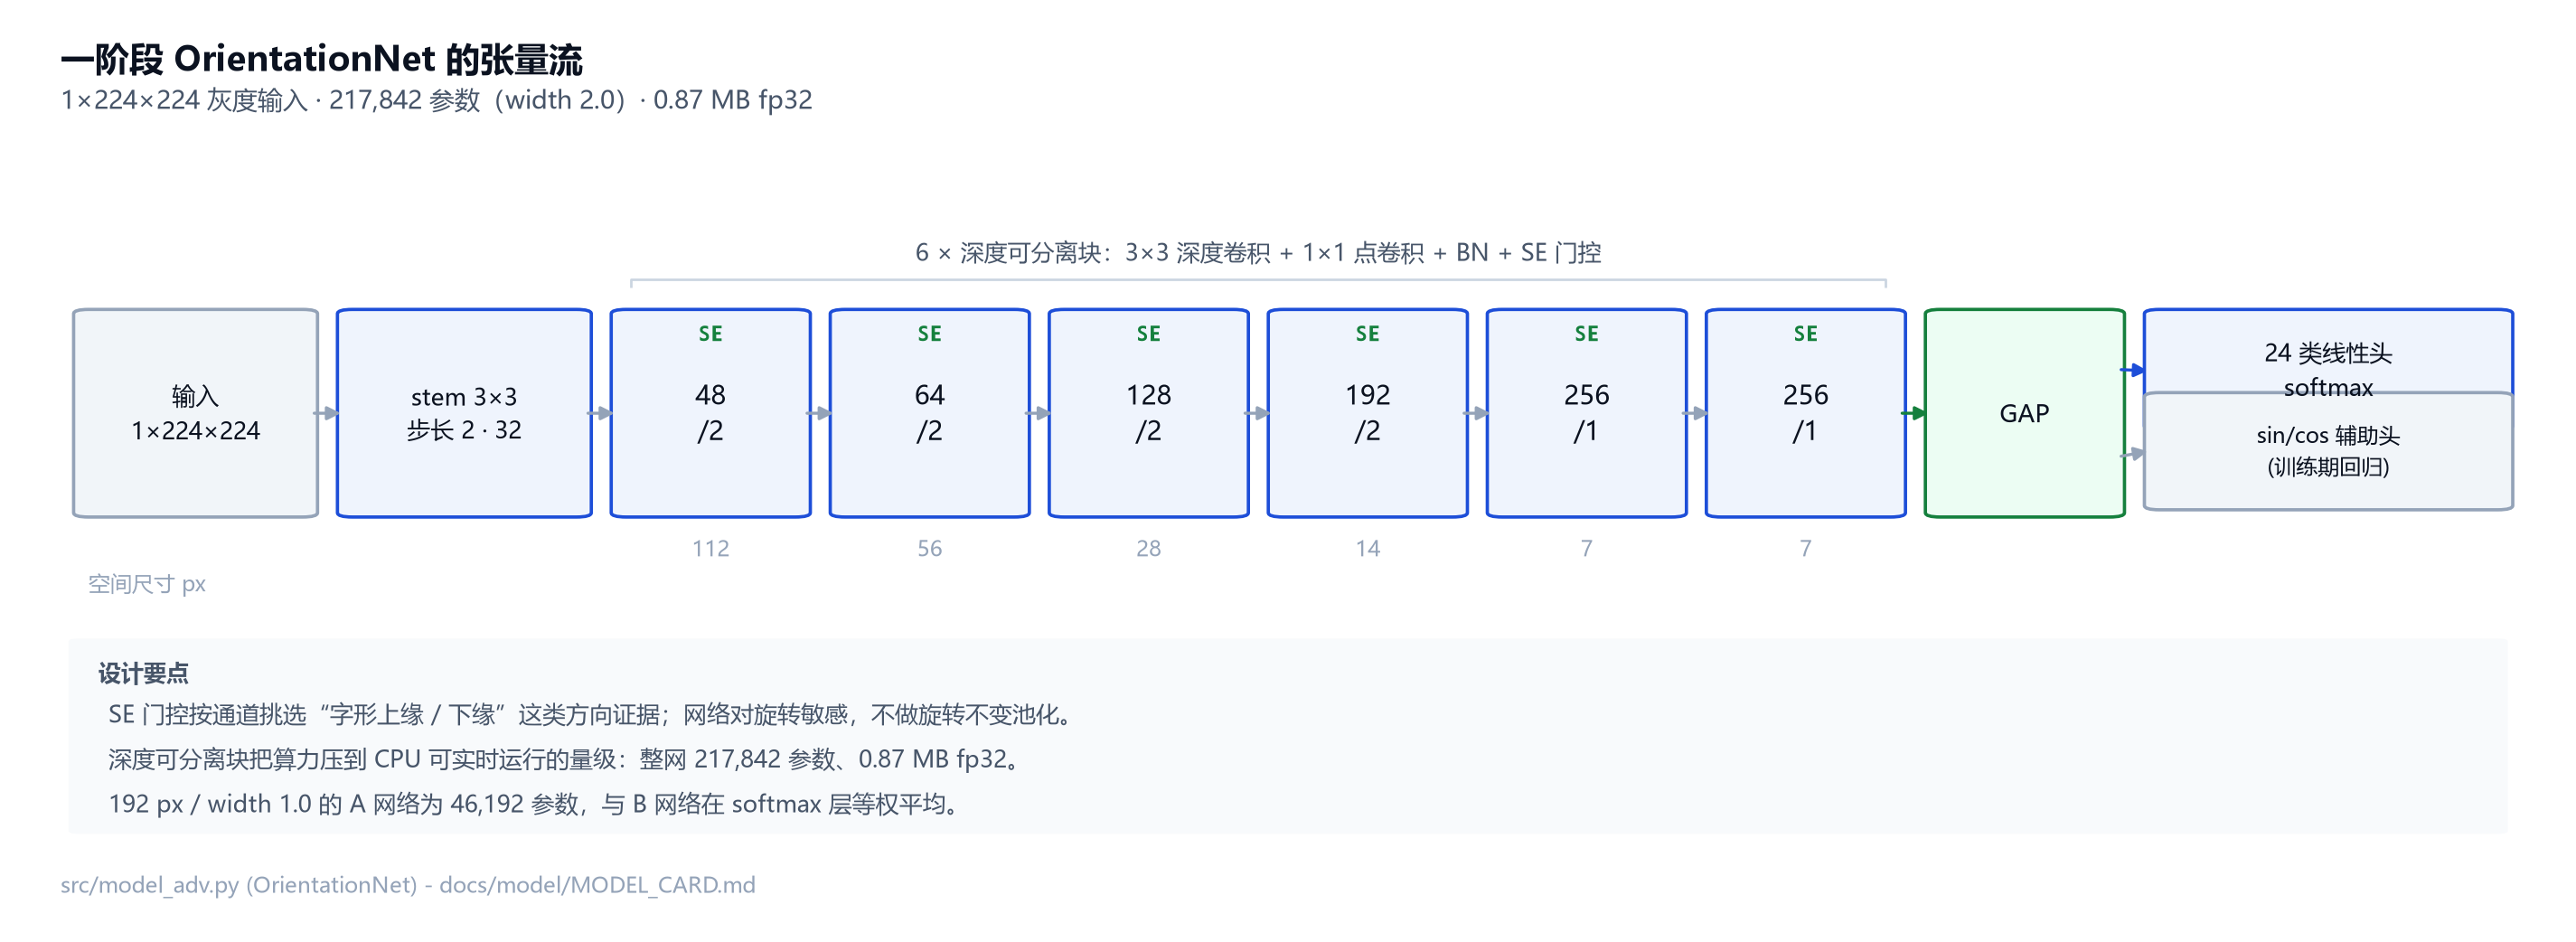
图 6 一阶段先用一次步长 2 的卷积把 224 px 输入降到 112,再用 6 个深度可分离块(48/64/128/192 各降采样一次,两个 256 保持分辨率),每块带 SE 门控。全局平均池化后接 24 类线性头与 sin/cos 辅助头,B 网络共 217,842 参数。网络刻意保持旋转敏感:方向判定需要“文字朝哪边”,而不是旋转不变性。
读图时注意网络刻意不做旋转不变性:方向判定需要的正是"文字朝向哪边"的证据,因此既没有旋转不变池化,也没有对极坐标做对称化。三个部件各有分工:深度可分离卷积 [17] 把算力压到 CPU 可实时的量级;SE 门控 [16] 让通道去选择"字形上缘/下缘""行基线走向"这类证据;批归一化 [18] 稳定小批量下的训练。
交付的一阶段由两个规模组成:B 网络 width 2.0、输入 224 px、217,842 参数;A 网络 width 1.0、输入 192 px、46,192 参数。二者在 softmax 层等权平均,合计 264,034 个参数。两个网络的误差互补来自分辨率与容量差异,而不是数据子集差异——它们看的是同一批 7,906 张训练原图。
5.3 角度解码与集成
本节回答:两个网络的输出如何合成一个角度,旋转增强如何在不增加参数的前提下实现。
每个网络输出 24 类分布。解码取两网 softmax 概率等权平均后的最大类索引 ,角度为 。等权平均而不是按验证集调权重,是为了减少一个在 845 张验证原图上拟合的自由度;集成成员数被预算限制在 2,因此互补性必须来自分辨率与容量差异 [22]。
四向旋转测试增强把输入旋转 后前向,再把输出概率沿类别轴滚动 格,最后求平均。这一步直接用到 24 类的循环结构:旋转 90° 对应类别平移 6 格,因此不需要额外的网络或参数。聚合发生在概率空间而不是角度空间,理由与 TTA 聚合的既有结论一致——角度空间平均在 0°/360° 附近会失效,而概率空间的滚动平均是良定义的 [23]。
5.4 四方向残差解析器
本节回答:第二级为什么是四选一,几何上如何定义,成本是多少。
一阶段最主要的残余错误是整数倍对称混淆:90° 与 270°、0° 与 180°。设一阶段预测为 、真实角为 +。把图像按 正立化后,页面相对正立仍偏着 ;训练与推理共用同一个渲染约定(按「负基准角 + 偏移」旋转、标签就是该偏移),因此解析器要输出的正是这个残余偏移 ,修正角为 。
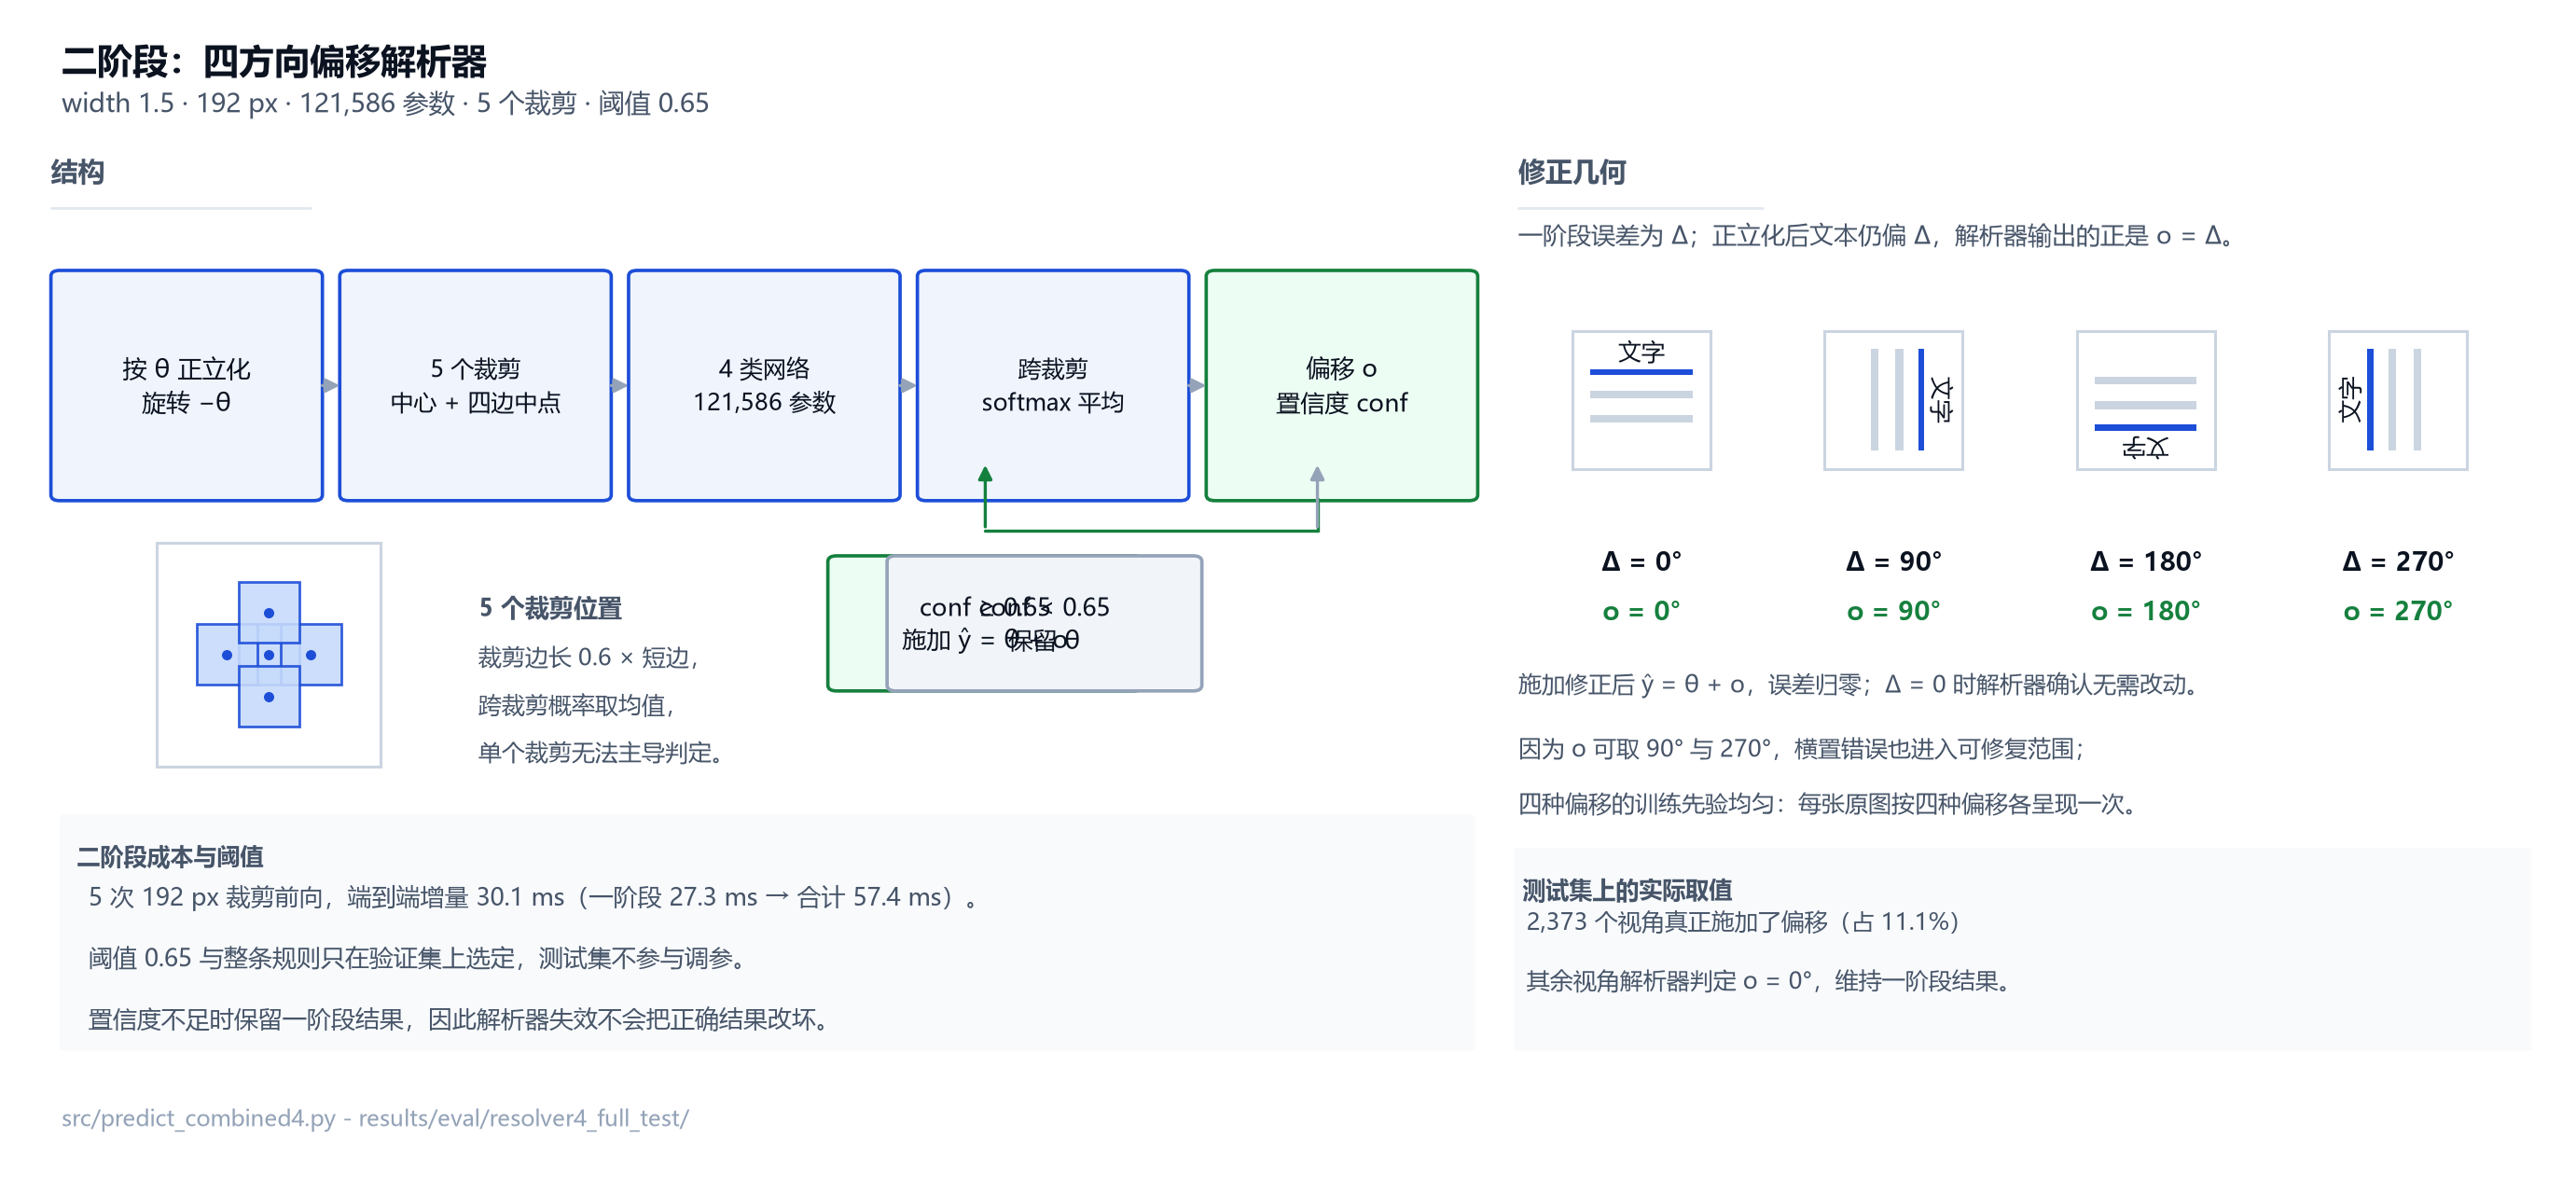
图 7 按预测角 θ 正立化后,图像仍带着 Δ 的残余偏移;解析器在 中心与四边中点共 5 个裁剪上各输出 4 类概率并取均值,得到偏移 o 与置信度。o 恰好等于 Δ,修正为 ŷ = θ + o,置信度 ≥0.65 时才施加。因为 o 可以取 90° 与 270°,横置错误也进入可修复范围。
读图时把左右两半分开:左半是结构——正立化后的图像取中心与四边中点共 5 个裁剪,每个裁剪输出 4 类概率,跨裁剪求均值;右半是几何——两个阶段共用同一个 ,一阶段不知道它是多少,解析器只需在四个整数倍上把它命名出来,修正公式 因此成立。因为 可以取 90° 与 270°,横置错误也在可修复范围内;而 只能在四个整数倍里取值,解析器就不可能把误差改到 15° 量级上去。
解析器与一阶段共用同一套骨干:width 1.5、256 px 输入、4 类输出、121,586 参数。新增成本就是这 121,586 个参数与 5 次 256 px 前向,而一阶段的圆周软标签结构完全复用。
5.5 训练目标与优化
本节回答:两个阶段各自优化什么、用什么优化器与调度、预算如何分配。
一阶段的损失是软标签交叉熵与辅助项之和:
其中 是辅助头输出,权重 ,只在带辅助头的 B 网络上生效。解析器是标准的四类交叉熵,附加标签平滑 0.05——这里用平滑的目的与一阶段的圆周软目标相同:避免模型对单一整数倍过度自信 [21]。
优化统一用 AdamW [20],配合余弦退火 [19];一阶段学习率 A 网络 3e-4、B 网络 4e-4,权重衰减 1e-4,批大小 64 与 48,梯度裁剪 2.0,B 网络开 EMA(衰减 0.999),固定种子 20261021。解析器学习率 1e-3,批大小 64,输入 256 px,裁剪尺度 0.60(抖动 0.25),14 轮 × 12,000 视图,固定种子 20261023。
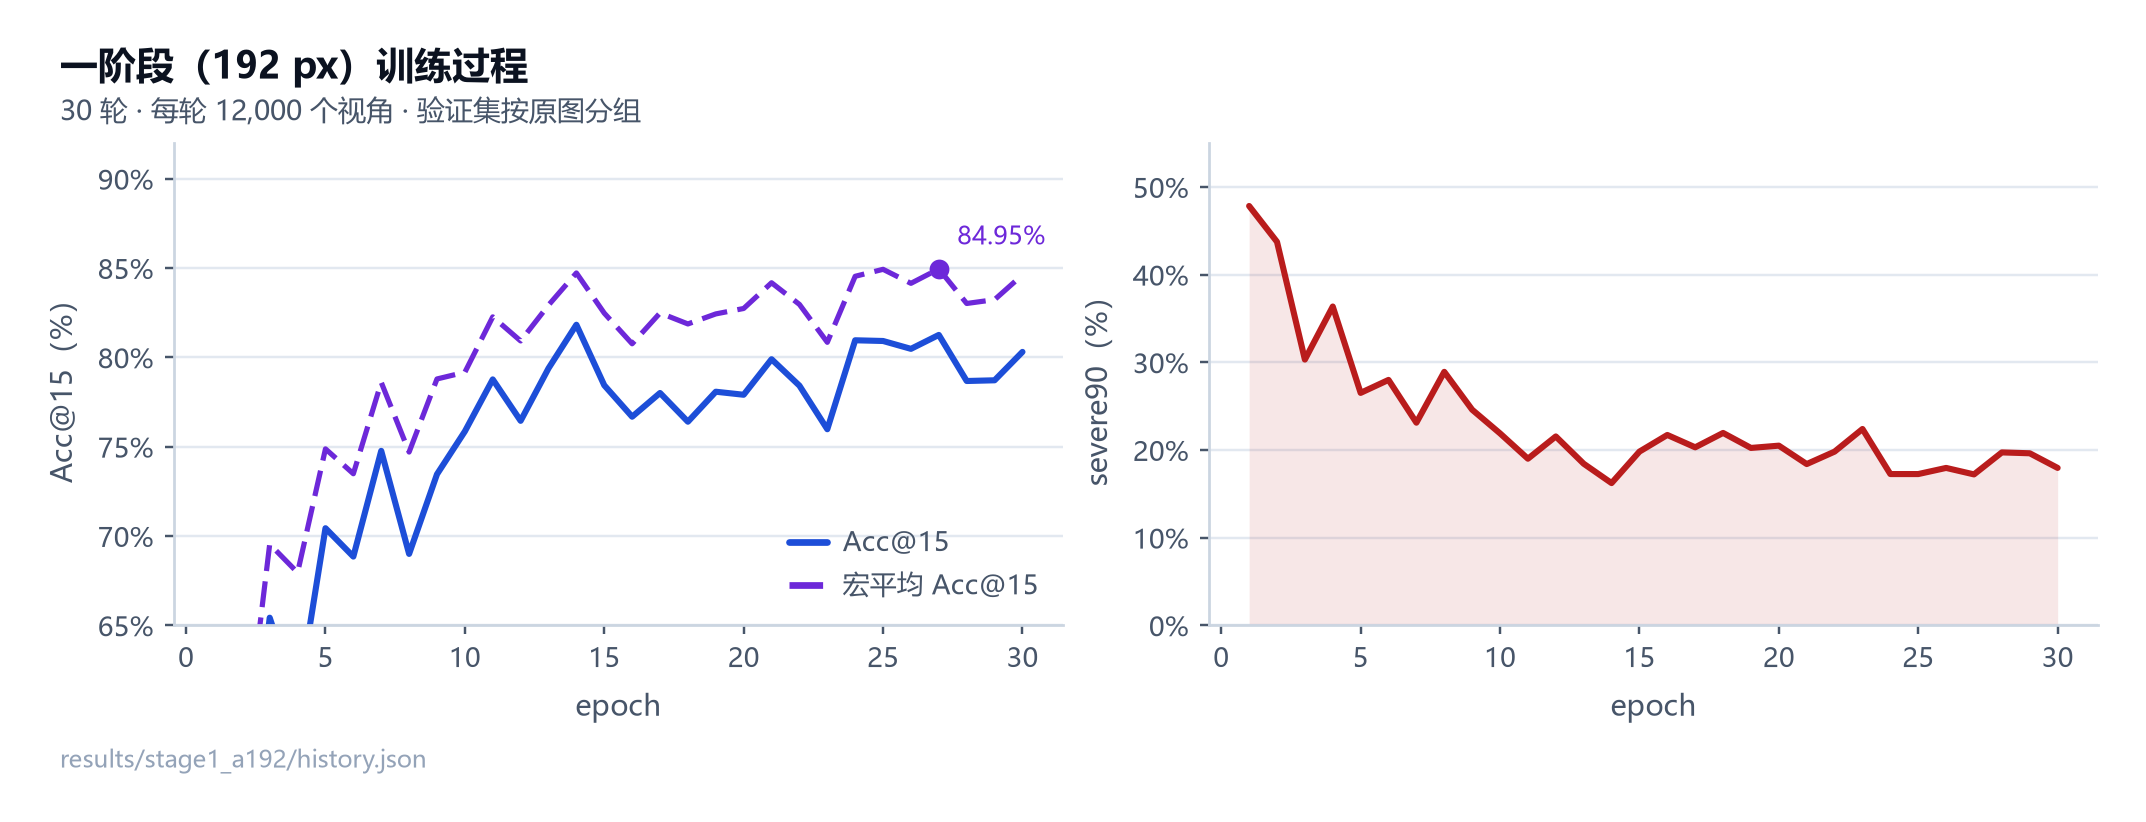
图 8 192 px 网络的 30 轮验证曲线:Acc@15 从第 1 轮的 43.67% 升到第 30 轮的 80.31%,按选择分数选出的检查点在第 25 轮(Acc@15 80.92%);右图的 severe90 从前几轮的四成以上降到约 14%。曲线在中后段进入缓慢改善区,说明剩余误差已不是训练不足,而是结构性的 90°/180° 对称混淆——这正是二阶段要处理的部分。
读一阶段曲线时看两条线的相对走势而不是终点:验证 Acc@15 随轮次抬升,severe90 同步下降,说明模型收敛的是"整体朝向"而不是只记住类中心;曲线后段进入平台,说明剩余误差已不是训练不足,而是结构性的整数倍混淆。按「域宏平均 Acc@15 − 2 × 域宏平均 severe90」选择检查点,A 网络最优在第 25 轮(验证 Acc@15 80.92%、severe90 17.26%),B 网络最优在第 30 轮(84.81%、13.99%);从第 1 轮到最优轮,A 由 43.67% 升到 80.92%,B 由 57.27% 升到 84.81%。
增强只做保方向的光度与轻度几何扰动(透视 0.30、弹性 0.18、模糊 0.25、JPEG 0.25、噪声 0.35),且一律在带标签的旋转之前施加。这条顺序不是细节:改变文字基线的强形变会让精确角度标签失效,而轻度几何扰动在图像域内的作用是模拟拍摄条件,其系统综述见 [29]。
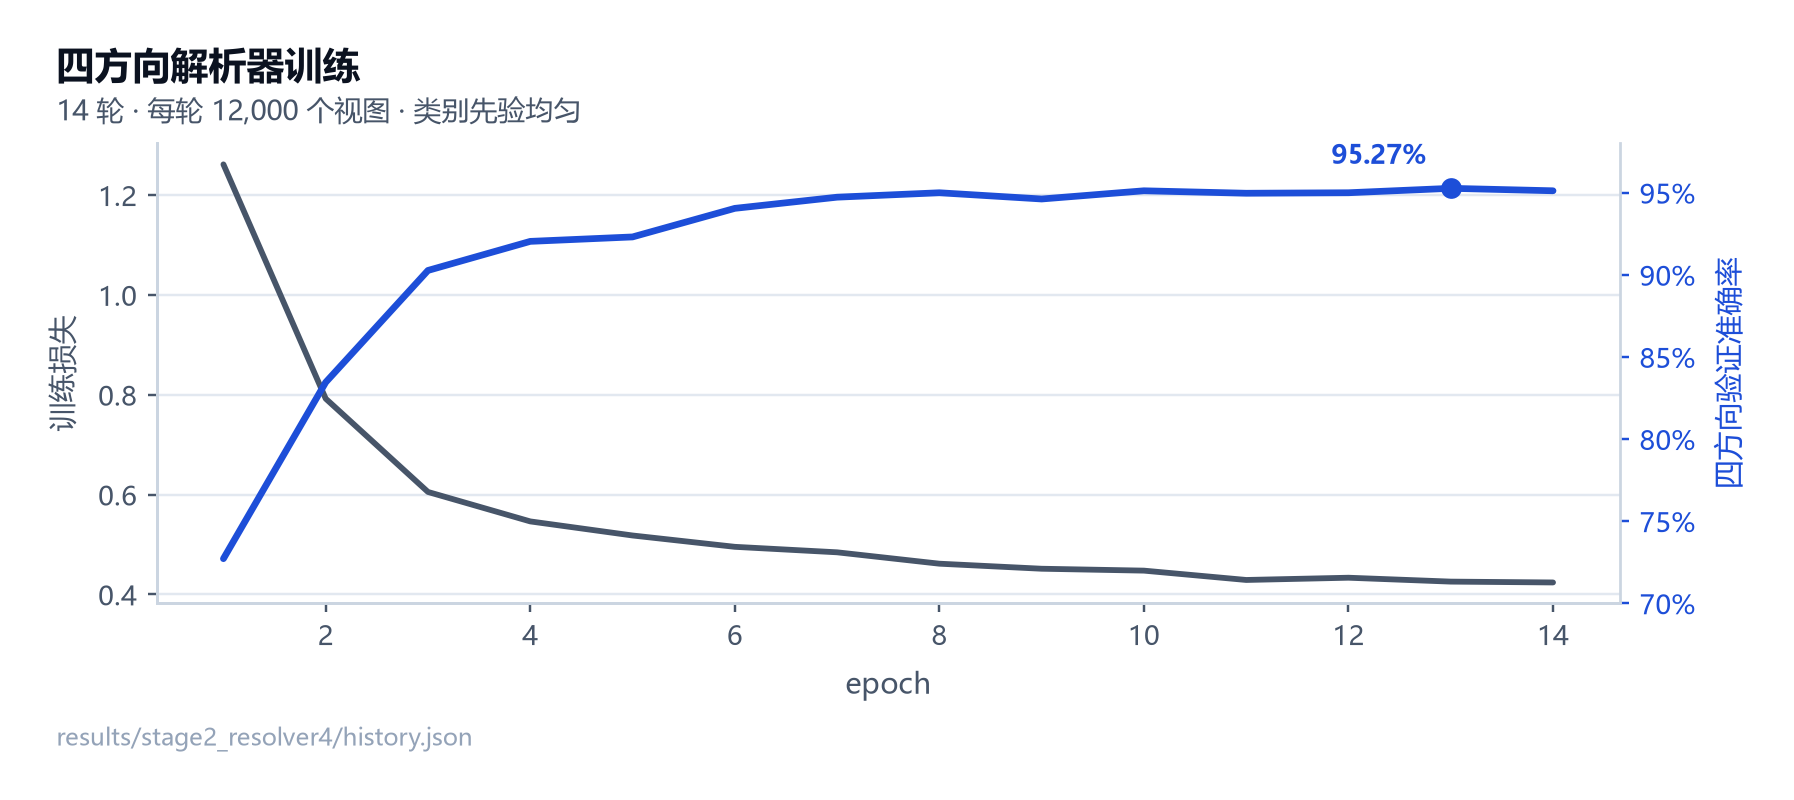
图 9 解析器的 14 轮训练:损失单调下降,四方向验证准确率在第 13 轮达到 95.27%。训练时每张原图按四种残余偏移各呈现一次,因此四个类别先验均匀,验证准确率可以直接当作偏移判定质量来读。
读解析器曲线时应关注收敛形状:损失从第 1 轮的 1.2616 降到第 14 轮的 0.4241,四方向验证准确率在第 2 轮就到 83.46%,此后缓慢爬到第 13 轮的 95.27%。前几轮拿走大头,说明"分辨四个整数倍"本身不难;此后每一轮只换来零点几个百分点,说明剩下的难点全在一阶段留下的边界样本上——这也解释了为什么解析器只需要 14 轮,而一阶段要 30 轮。
6 实验设置
本节回答:比较了哪些配置、在什么平台、以什么协议测量,以及成本如何构成。
本章只比较两个配置:仅一阶段(24 类集成 + TTA4)与交付配置(一阶段 + 四方向二阶段)。两者跑在完全相同的 21,392 个视角上,来自同一份逐视角产物 results/eval/test/test_pipeline_views.csv,逐行对齐已校验(一阶段角度重算与产物中的 err_none 列最大偏差 0.0000°),因此任意两组数字之间的差可直接做按原图分组的配对自助法。阈值在比较开始前已于验证集固定为 0.65,测试集只跑一次。
平台是 AMD Ryzen 7 8745H(8 核 16 线程),执行环境为 WSL2 Debian 13,PyTorch 2.14.1,Python 3.12.14,全程 CPU 执行(torch.cuda.is_available() 为假),无 GPU 参与。种子:一阶段训练 20261021、解析器训练 20261023、自助法 20261024。
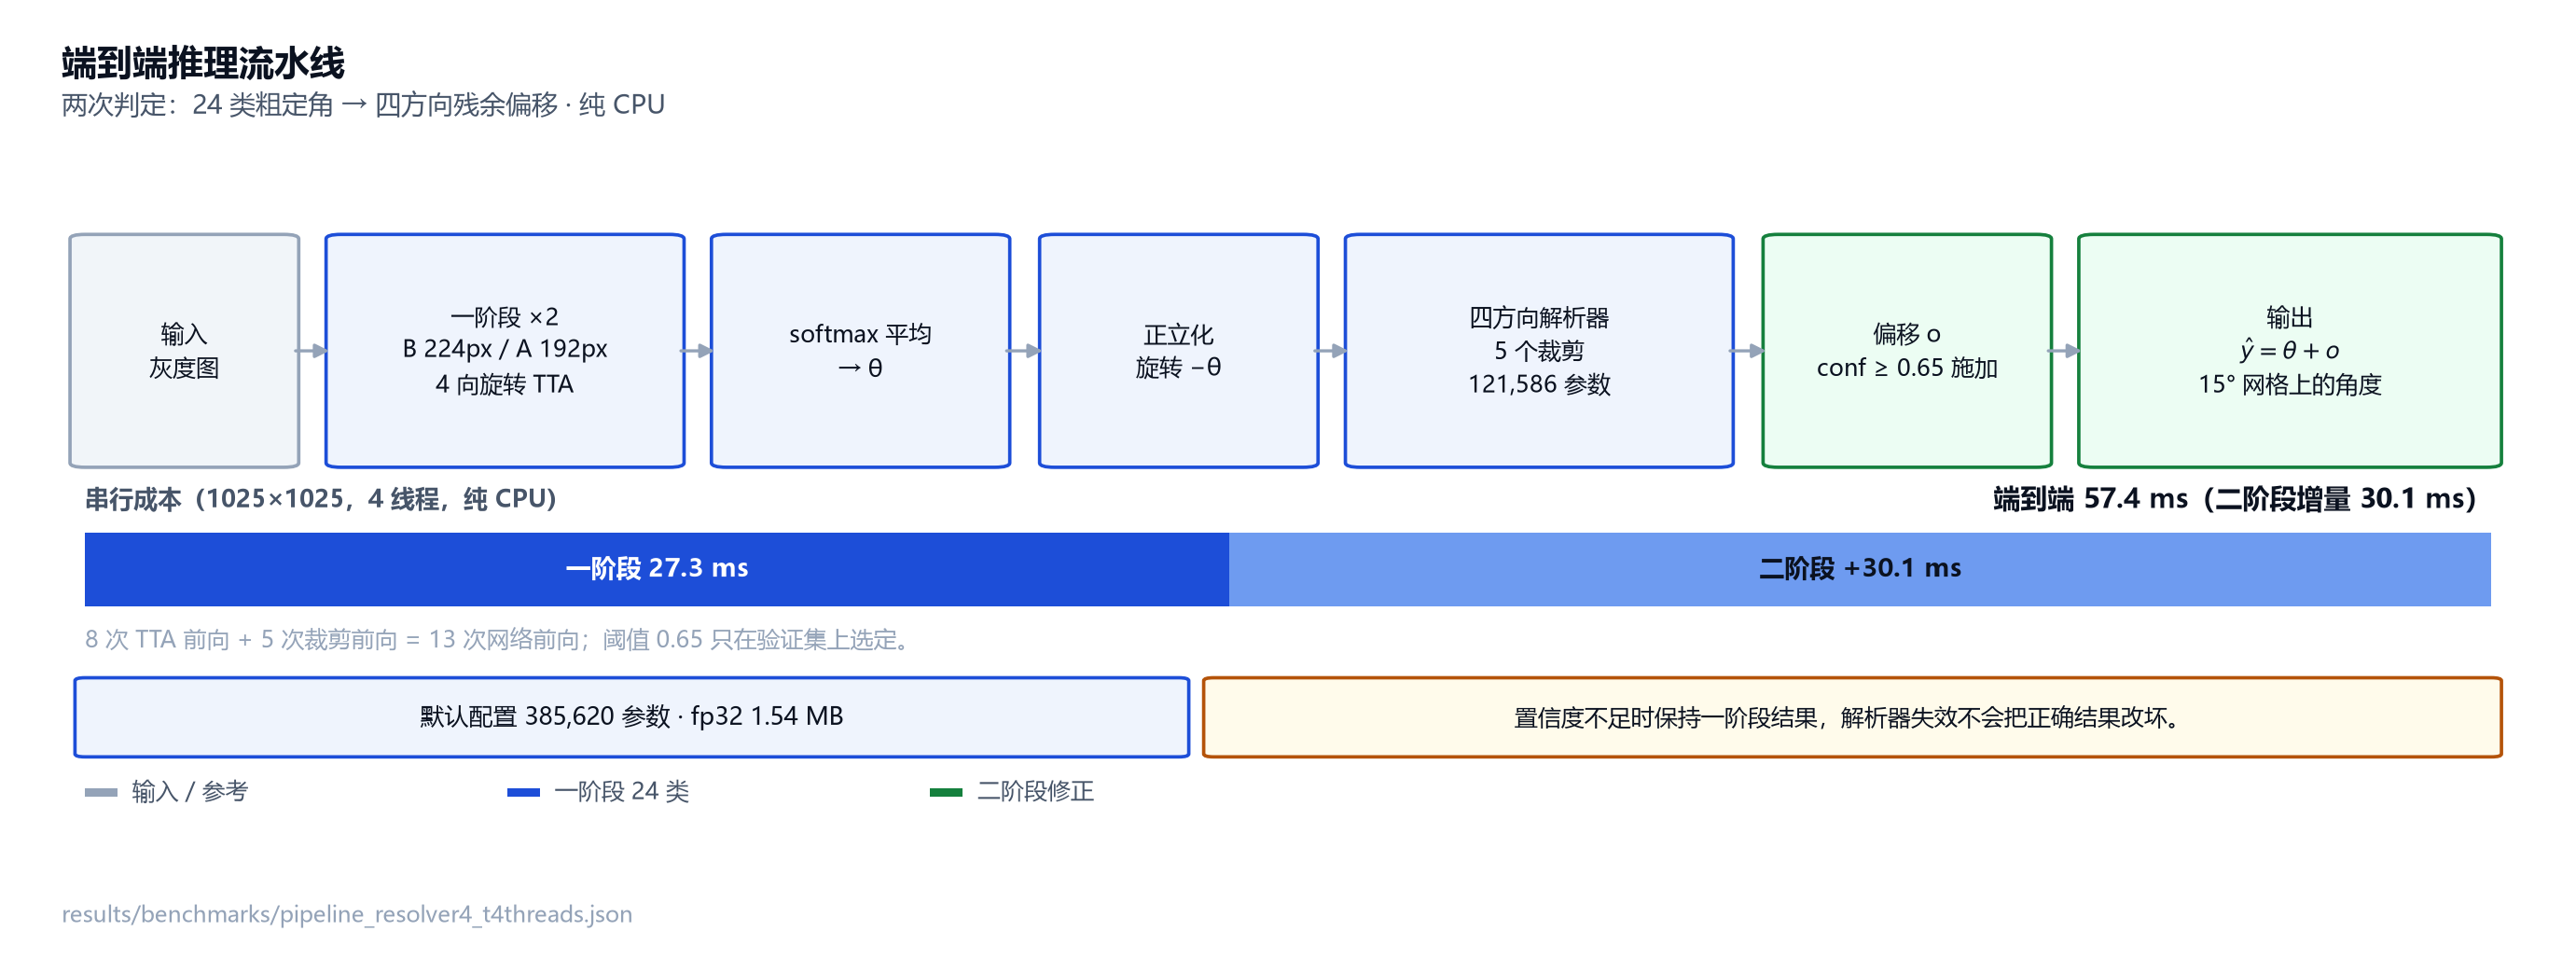
图 10 两个 24 类网络各自做 4 向旋转测试增强,softmax 平均得到 θ;图像按 θ 正立化后由四方向解析器给出偏移 o,输出 ŷ = θ + o。一阶段 27.3 ms、二阶段增量 30.1 ms,端到端 57.4 ms(4 线程,1025×1025,纯 CPU)。默认配置共 385,620 参数、fp32 1.54 MB。
读图时看方框之间的箭头数量:一阶段是 2 个网络 × 4 个 TTA 方向 = 8 次前向,二阶段是 5 个裁剪 = 5 次前向;串行成本几乎全部由这 13 次小图前向决定,与图像内容无关。默认配置共 385,620 个参数、fp32 1.54 MB,端到端中位数 57.4 ms(4 线程、1025×1025 页面、纯 CPU),其中一阶段 27.3 ms、二阶段增量 30.1 ms。二阶段在不确定时保留一阶段结果,失效方式是退回到 87.85% 的一阶段水平,而不是把正确结果改坏——7.4 节的逐视角转移统计给出直接读数。
7 结果
本节回答:这套系统在留出测试集上达到什么水平,增益来自哪里,代价是多少。
7.1 主结果
本节回答:两个配置的整体指标是多少,差值的区间是否排除 0,离验收门槛还差多少。
表 3 给出测试集主结果。加入四方向二阶段后,Acc@15 从 87.85% 升到 98.05%,severe90 从 11.31% 降到 1.21%,MAE 从 21.34° 降到 5.06°,宏 Acc@15 从 91.21% 升到 98.50%。
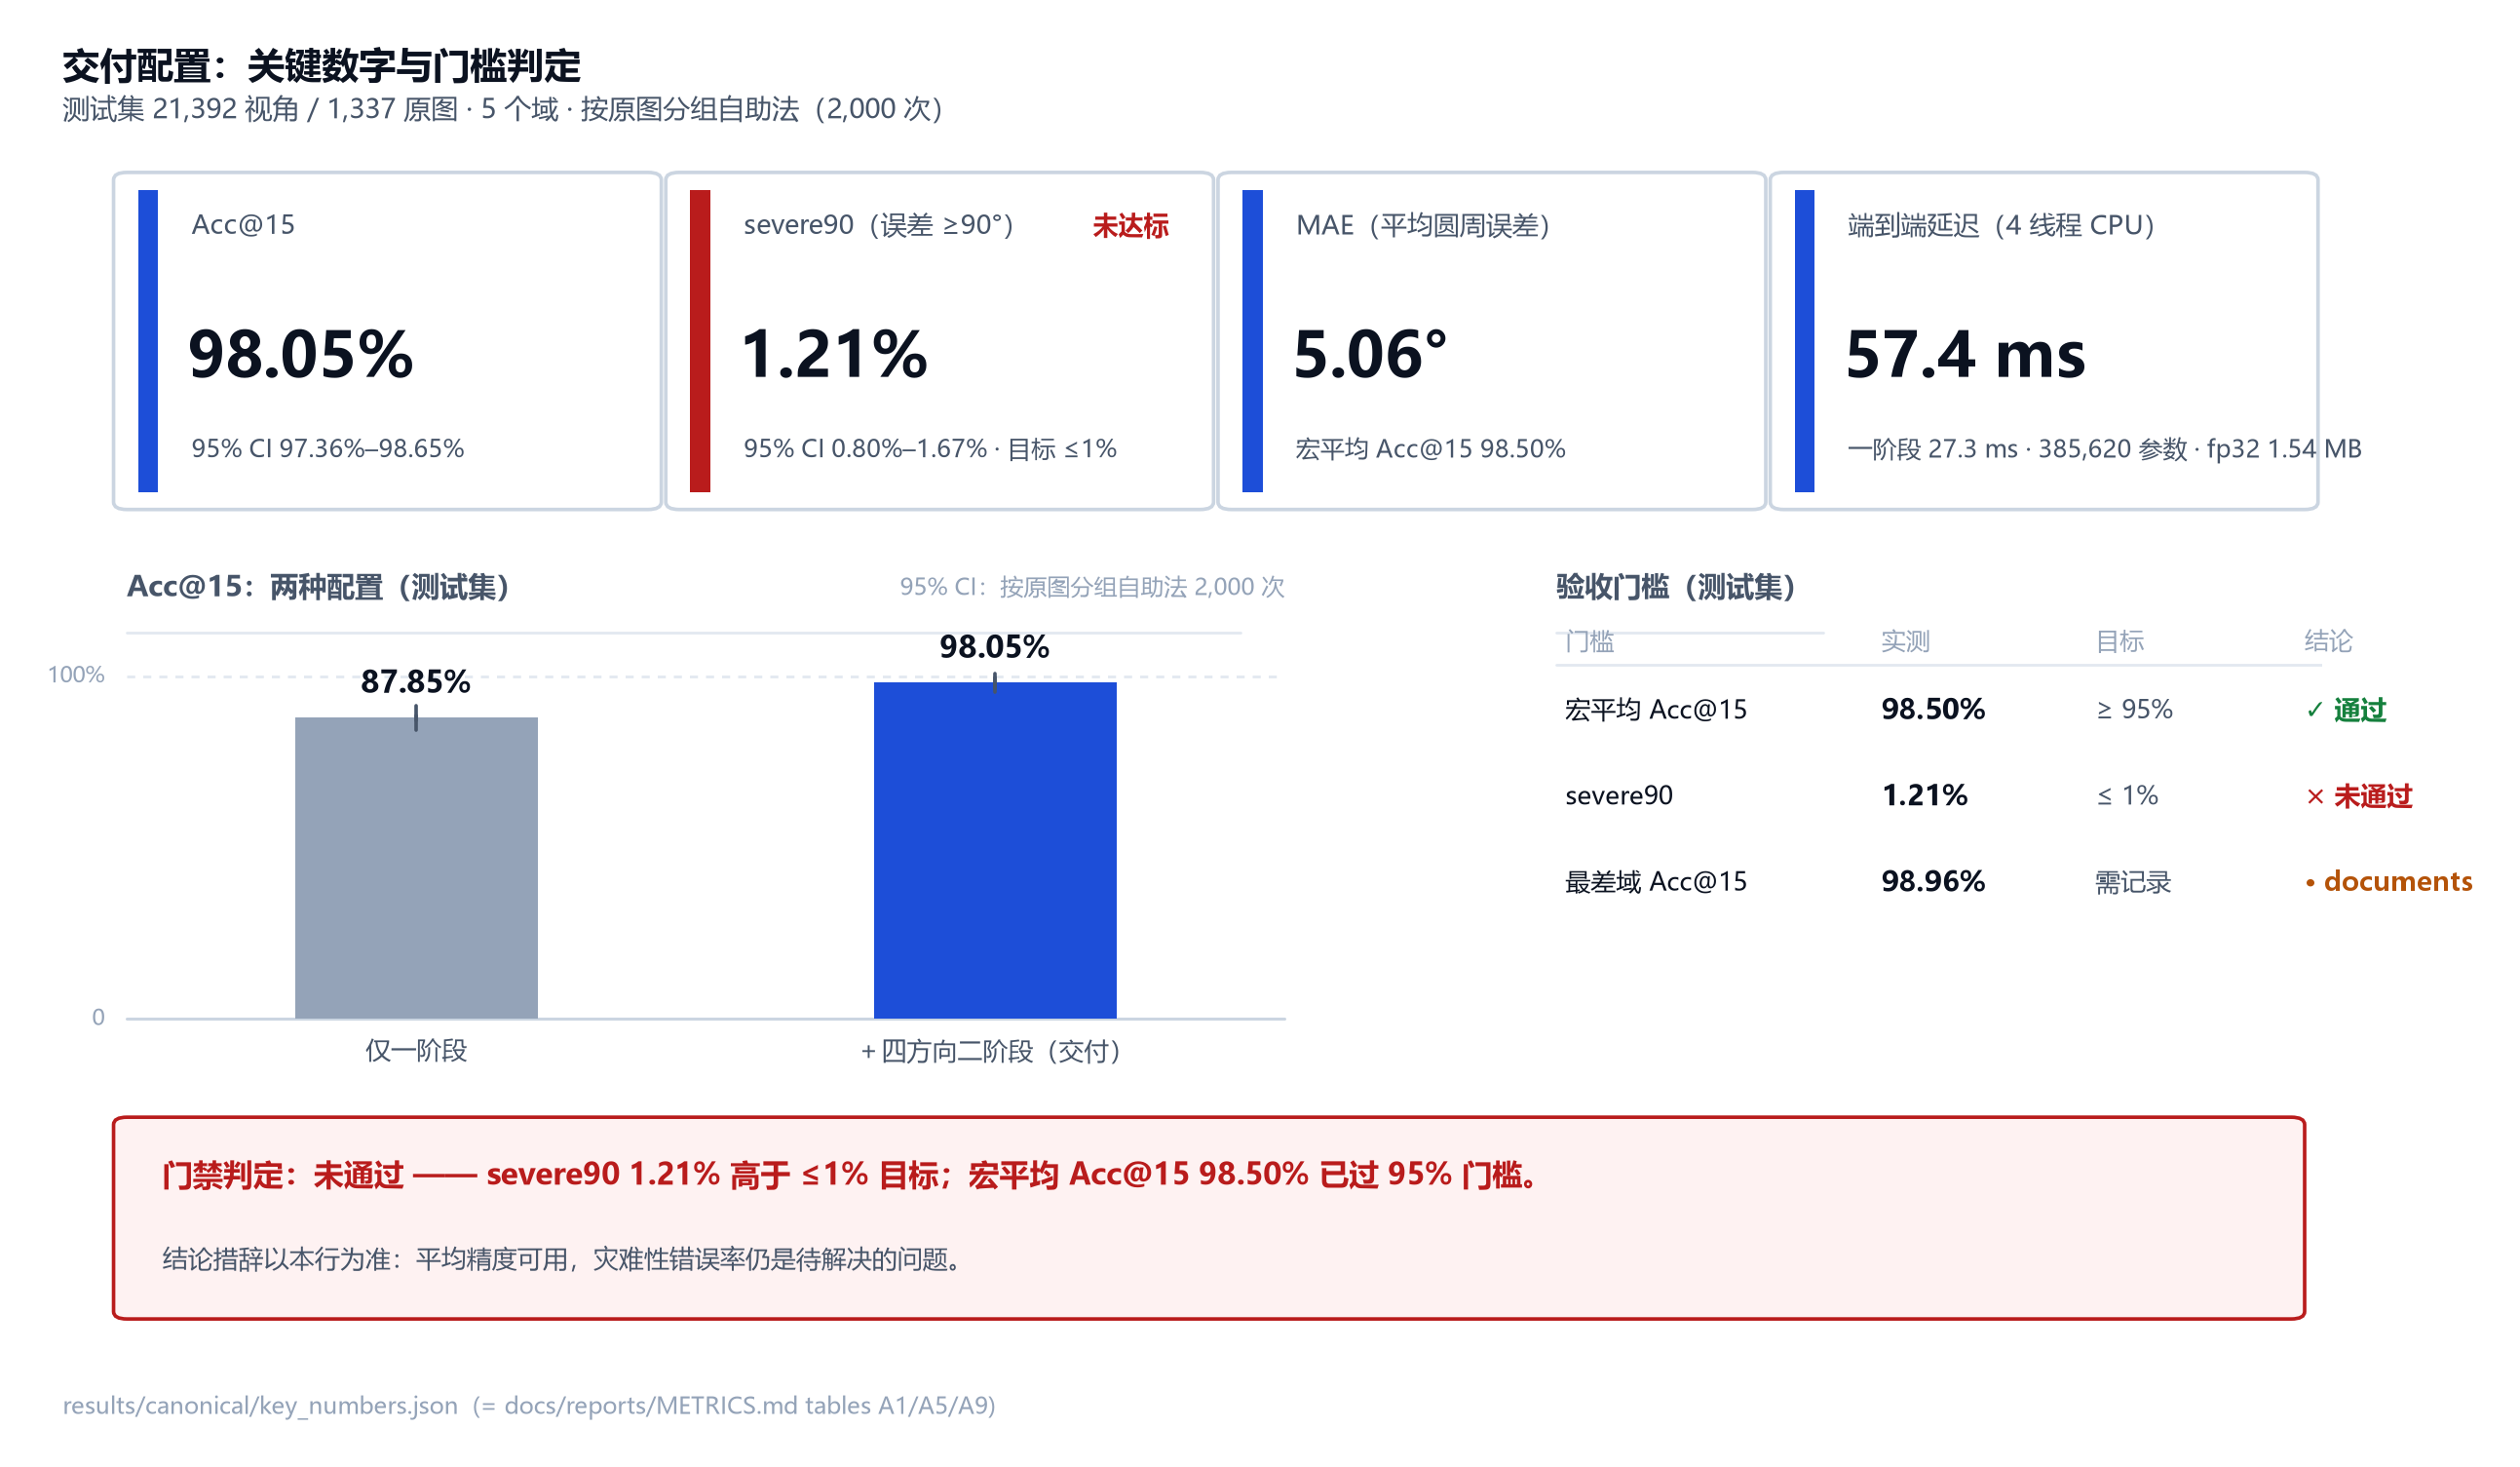
图 11 在 21,392 个测试视角上,交付配置的 Acc@15 达到 98.05%(95% CI 97.36–98.65),MAE 5.06°,端到端 57.4 ms。severe90 为 1.21%,高于 ≤1% 的验收目标;宏平均 Acc@15 98.50% 已过 95% 门槛。因此门禁判定为未通过——平均精度可用,灾难性错误率仍是待解决的问题。
读这张总览图时先看四个数的相对位置:平均精度与宏平均都已过 95% 目标线,灾难性错误率仍在 1% 目标线之上;四个指标里只有 severe90 一格未达标,而它恰好是最难用平均精度替代的那一格。
表 3 测试集主结果(1,337 张原图 / 21,392 个视角 / TTA4)
| 配置 | n | Acc@7.5 | Acc@15(95% CI) | severe90(95% CI) | MAE | 宏 Acc@15(95% CI) | off90 | off180 |
|---|---|---|---|---|---|---|---|---|
| 仅一阶段(24 类集成 + TTA4) | 21,392 | 74.30% | 87.85%(86.28–89.31) | 11.31%(9.96–12.70) | 21.34° | 91.21%(90.05–92.24) | 278 | 589 |
| 一阶段 + 四方向二阶段(交付) | 21,392 | 82.90% | 98.05%(97.36–98.65) | 1.21%(0.80–1.67) | 5.06° | 98.50%(97.92–99.02) | 16 | 10 |
按原图分组的配对比较:Acc@15 提高 10.20 pp(95% CI 8.80 … 11.61),severe90 下降 10.10 pp(−11.47 … −8.72),两个区间都不含 0。读表要点:off90 与 off180 两列是机制证据——一阶段的 278 个"正好错 90°"与 589 个"正好错 180°"是两类不同的失败,交付配置把前者压到 16、后者压到 10,说明二阶段不是把误差推平,而是把这两类对称错误分别消掉了。Acc@7.5 的提升幅度(74.30% → 82.90%)小于 Acc@15,说明被修正的视角多数落在 7.5°–15° 这一档:二阶段改的是整数倍方向,不是细倾角,细倾角仍由一阶段负责。
表 8 验收门槛判定(测试集)
| 门槛 | 目标 | 实测(测试集) | 结论 |
|---|---|---|---|
| 宏平均 Acc@15 | ≥ 95% | 98.50% | 通过 |
| severe90(≥90°) | ≤ 1% | 1.21% | 未通过 |
| 最差域 Acc@15 | 项目内约定 | 94.27%(scene_text) | 最弱域,如实记录 |
读表要点:通过的是宏平均,未通过的是 severe90(1.21% 对 1%,差 0.21 pp),最差域为 scene_text 的 94.27%。两项发布条件只满足其一,因此在 severe90 降到 1% 以下之前,本文不出现"通过验收"“已达标”“可直接投产"这类表述。最差域一项写”—"而非"通过"是有意为之:这一门槛应由业务成本决定,而不是由报告作者决定。
7.2 消融:仅一阶段
本节回答:二阶段究竟贡献了多少,它的贡献是否只是"多算了一点"。
消融的形式是"去掉二阶段、保留其余全部设定":同一对 24 类权重、同样的四向 TTA、同一批 21,392 个视角。表 3 的第一行就是该配置:Acc@7.5 74.30%、Acc@15 87.85%、severe90 11.31%、MAE 21.34°、宏 Acc@15 91.21%,off90 278、off180 589。
这组数字说明三点。第一,一阶段本身已经把绝大多数视角控制在 15° 以内,87.85% 的 Acc@15 与 21.34° 的 MAE 之间的落差来自少数大误差视角——MAE 被 90°/180° 档拉高,而不是被普遍的小倾角误差拉高。第二,一阶段的失败几乎全部是整数倍失败:278 + 589 个整数倍错误占 21,392 个视角的 4.05%,而近失档(15°–45°)只有 0.21%。第三,正因为失败如此集中,第二级只需要回答四个类别就能覆盖主要错误来源,这也是本文把复核做成四选一而不是再训练一个 24 类网络的直接理由。
7.3 分域与分来源
本节回答:增益在五个域、六个来源上如何分布,哪一格最弱。
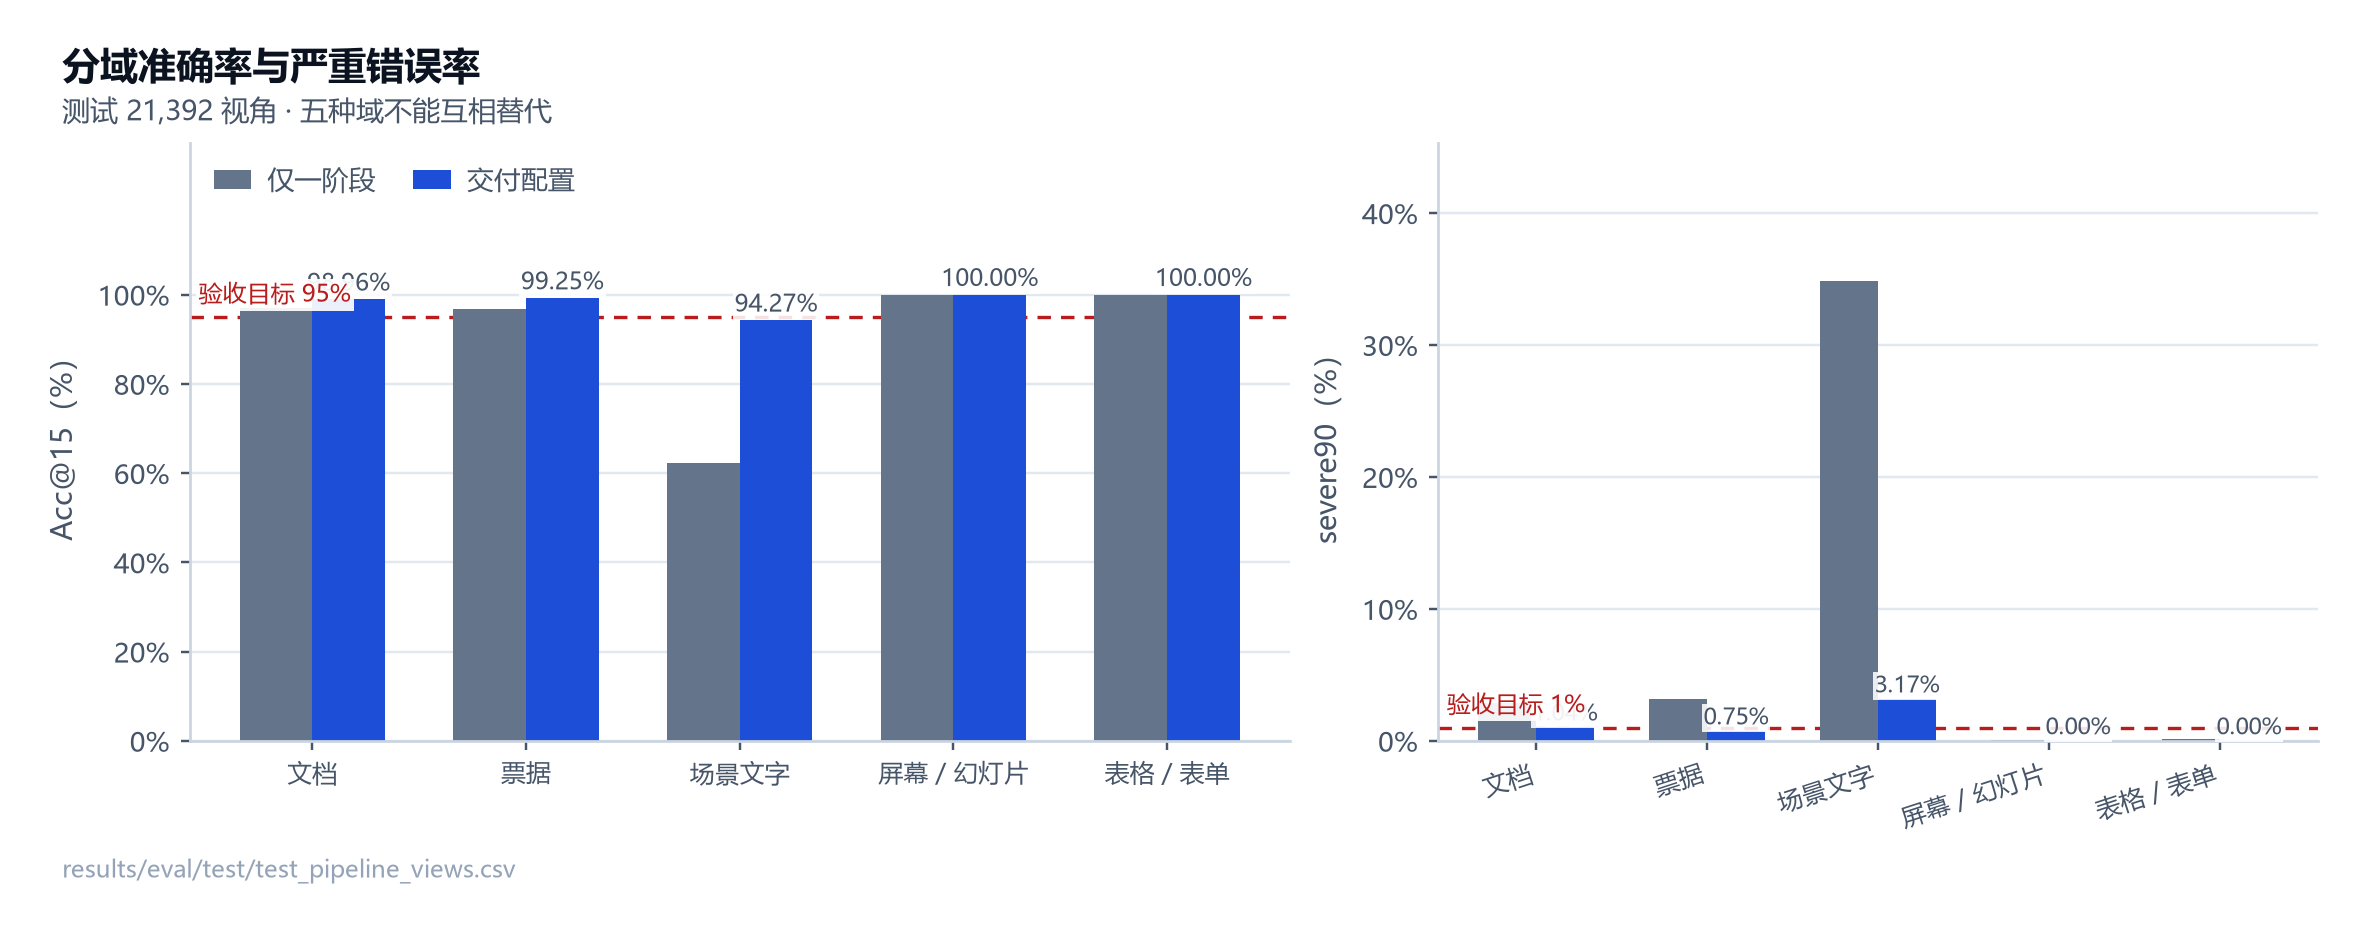
图 12 左图是两种配置的分域 Acc@15,虚线为 95% 验收目标;右图是 severe90 与 1% 目标线。二阶段把 scene_text 从 62.34% 拉到 94.27%、receipts 从 96.77% 拉到 99.25%;唯一没过 95% 的是 scene_text,其余四域都在 98.96% 以上,screens_slides 与 tables_forms 已达 100%。但 severe90 最高的仍是 scene_text(3.17%),documents 次之(1.04%)——要补难例的是场景文字,不是 documents。
读图时按左右两侧分别取结论:左图看哪些域过了 95% 目标线——只有 scene_text(94.27%)没过,documents 已到 98.96%,其余三域为 99.25%、100.00%、100.00%;右图看 severe90,最高的是 scene_text 3.17%,其次是 documents 1.04%,其余三域都不超过 0.75%。两侧合起来读:Acc@15 的短板只剩 scene_text 一处,而 severe90 的短板在 scene_text 与 documents 两处。
表 4 分域结果(测试)
| 域 | 视角数 | 一阶段 Acc@15 | 交付 Acc@15 | 一阶段 severe90 | 交付 severe90 | 交付 MAE | 交付 off90 | 交付 off180 |
|---|---|---|---|---|---|---|---|---|
| documents | 768 | 97.14% | 98.96% | 2.86% | 1.04% | 4.60° | 0 | 0 |
| receipts | 7,216 | 96.77% | 99.25% | 3.15% | 0.75% | 4.24° | 0 | 0 |
| scene_text | 6,208 | 62.34% | 94.27% | 34.86% | 3.17% | 8.57° | 16 | 10 |
| screens_slides | 6,400 | 99.92% | 100.00% | 0.08% | 0.00% | 2.90° | 0 | 0 |
| tables_forms | 800 | 99.88% | 100.00% | 0.12% | 0.00% | 2.94° | 0 | 0 |
读表要点:收益最集中的是 scene_text(Acc@15 提高 31.93 pp、severe90 从 34.86% 降到 3.17%),它的视角数第三多,因此这一域的改善直接决定了总体数字;五个域在交付配置下都不低于一阶段,0.65 的门控把改坏压到了不改变任何一域方向的量级。最弱的一格是 scene_text 的 94.27%,它是唯一没到 95% 的域;documents 已经过线(98.96%),但 severe90 1.04% 在五域中仅次于 scene_text、MAE 4.60° 亦是第二高,且该域只有 768 个视角(48 张测试原图),区间最宽,单点数值不宜当作稳定估计。另有一处需要解释:documents 的 off90 与 off180 都是 0,而其 severe90 为 1.04%——这说明该域的严重误差落在整数倍之间(60°–120° 一类),不是四方向解析器的输出空间所能修正的形态。
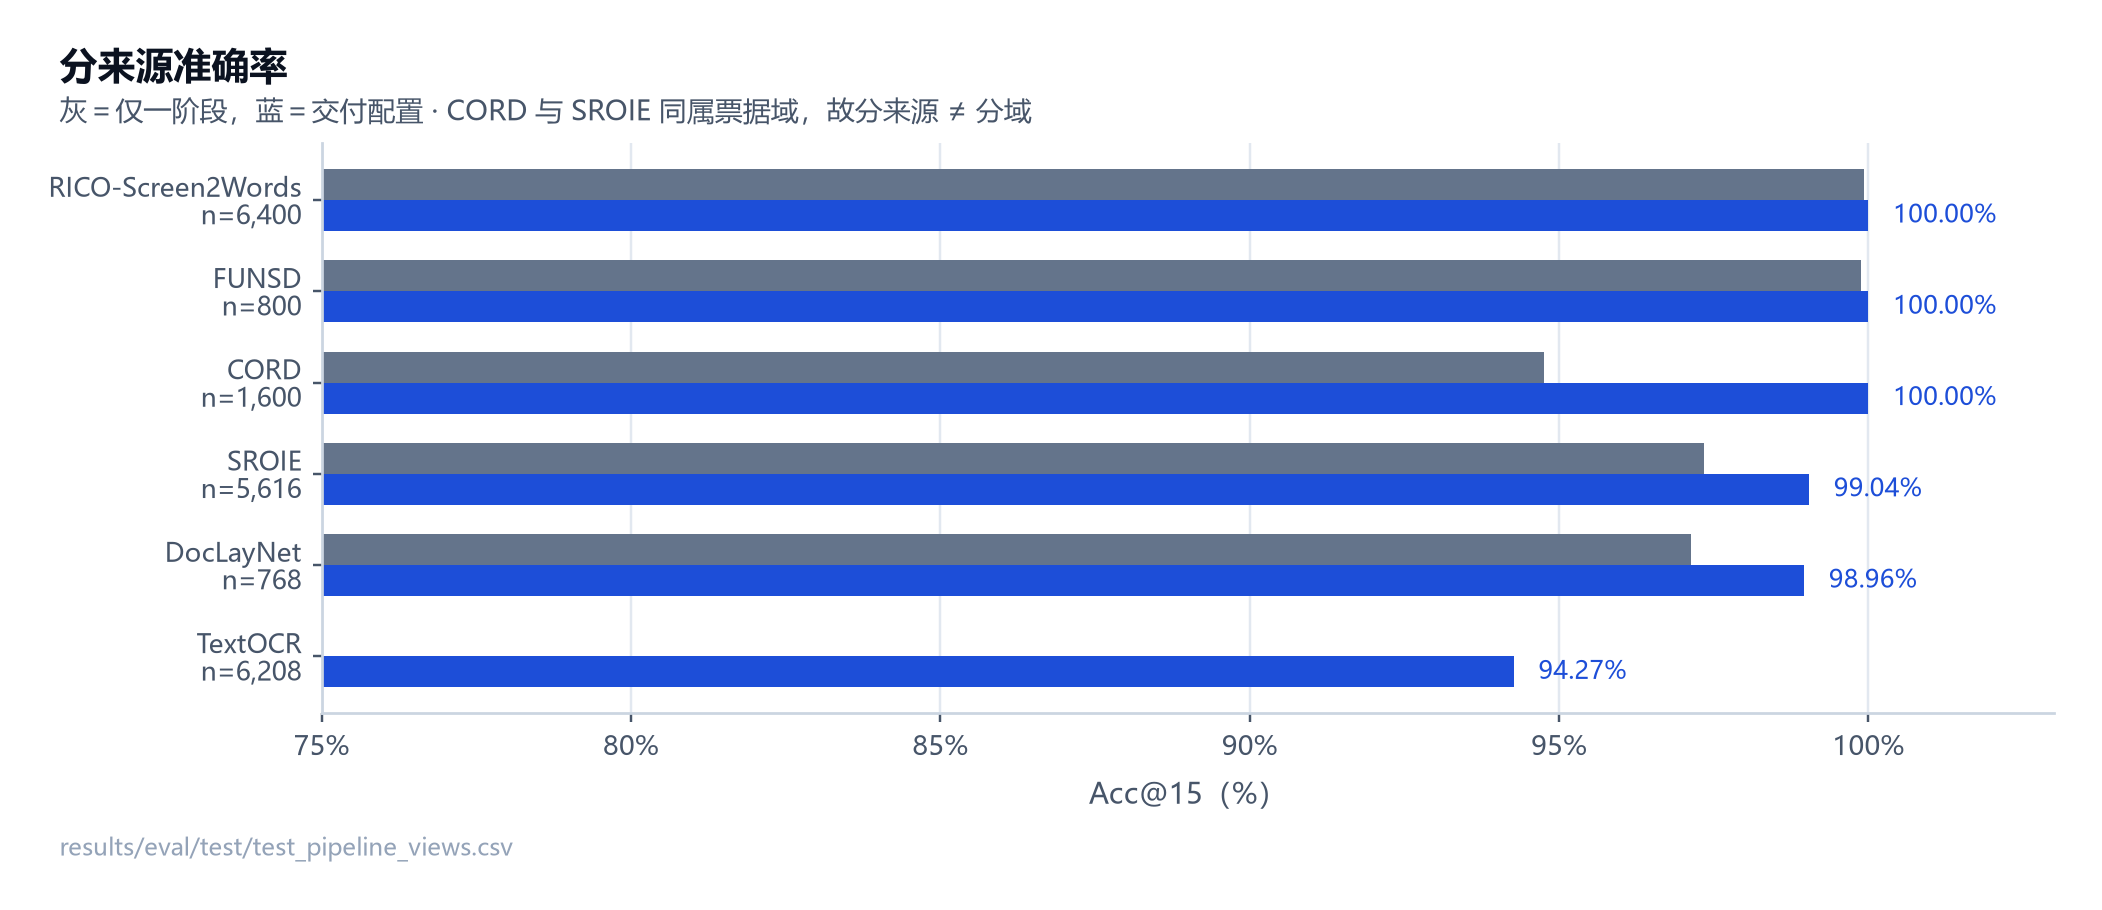
图 13 同一测试集按数据来源拆开,下方标注该来源的视角数。增益集中在两处:TextOCR +31.93 pp、CORD +5.25 pp(并做到 100.00%、severe90 归零);SROIE 与 DocLayNet 也有小幅提升(+1.69、+1.82 pp),FUNSD 与 RICO 在一阶段已接近饱和(+0.12、+0.08 pp)。六个来源在交付配置下都不低于一阶段,没有出现改坏多于修好的来源。
读图时不要把它和分域图当成同一件事:CORD 与 SROIE 同属 receipts 域,但两者在分域表里被合成一个数字,在来源图上却分开显示;两者的差距说明域内来源差异与域间差异同量级——只看域名会丢掉这部分方差,只看来源名又看不见域级的采样权重。
表 5 分来源结果(测试)
| 来源 | 域 | 视角数 | 一阶段 Acc@15 | 交付 Acc@15 | 一阶段 severe90 | 交付 severe90 | 交付 MAE |
|---|---|---|---|---|---|---|---|
| CORD | receipts | 1,600 | 94.75% | 100.00% | 4.88% | 0.00% | 3.17° |
| SROIE | receipts | 5,616 | 97.35% | 99.04% | 2.65% | 0.96% | 4.55° |
| DocLayNet | documents | 768 | 97.14% | 98.96% | 2.86% | 1.04% | 4.60° |
| FUNSD | tables_forms | 800 | 99.88% | 100.00% | 0.12% | 0.00% | 2.94° |
| RICO-Screen2Words | screens_slides | 6,400 | 99.92% | 100.00% | 0.08% | 0.00% | 2.90° |
| TextOCR | scene_text | 6,208 | 62.34% | 94.27% | 34.86% | 3.17% | 8.57° |
读表要点:收益集中在两个来源——TextOCR 的 Acc@15 提高 31.93 pp、CORD 提高 5.25 pp(并做到 100.00%、severe90 归零);SROIE 与 DocLayNet 也有小幅提升(+1.69 pp、+1.82 pp),FUNSD 与 RICO 在一阶段已接近饱和(+0.12 pp、+0.08 pp)。六个来源在交付配置下都不低于一阶段,没有出现"改坏多于修好"的来源。按三项指标综合看,DocLayNet 是仅次于 TextOCR 的第二难来源:交付 Acc@15 98.96%、severe90 1.04%、MAE 4.60°,都不如其余四个来源。
7.4 角度切片与误差解剖
本节回答:增益是否依赖角度落在类中心,误差在改写前后如何迁移。
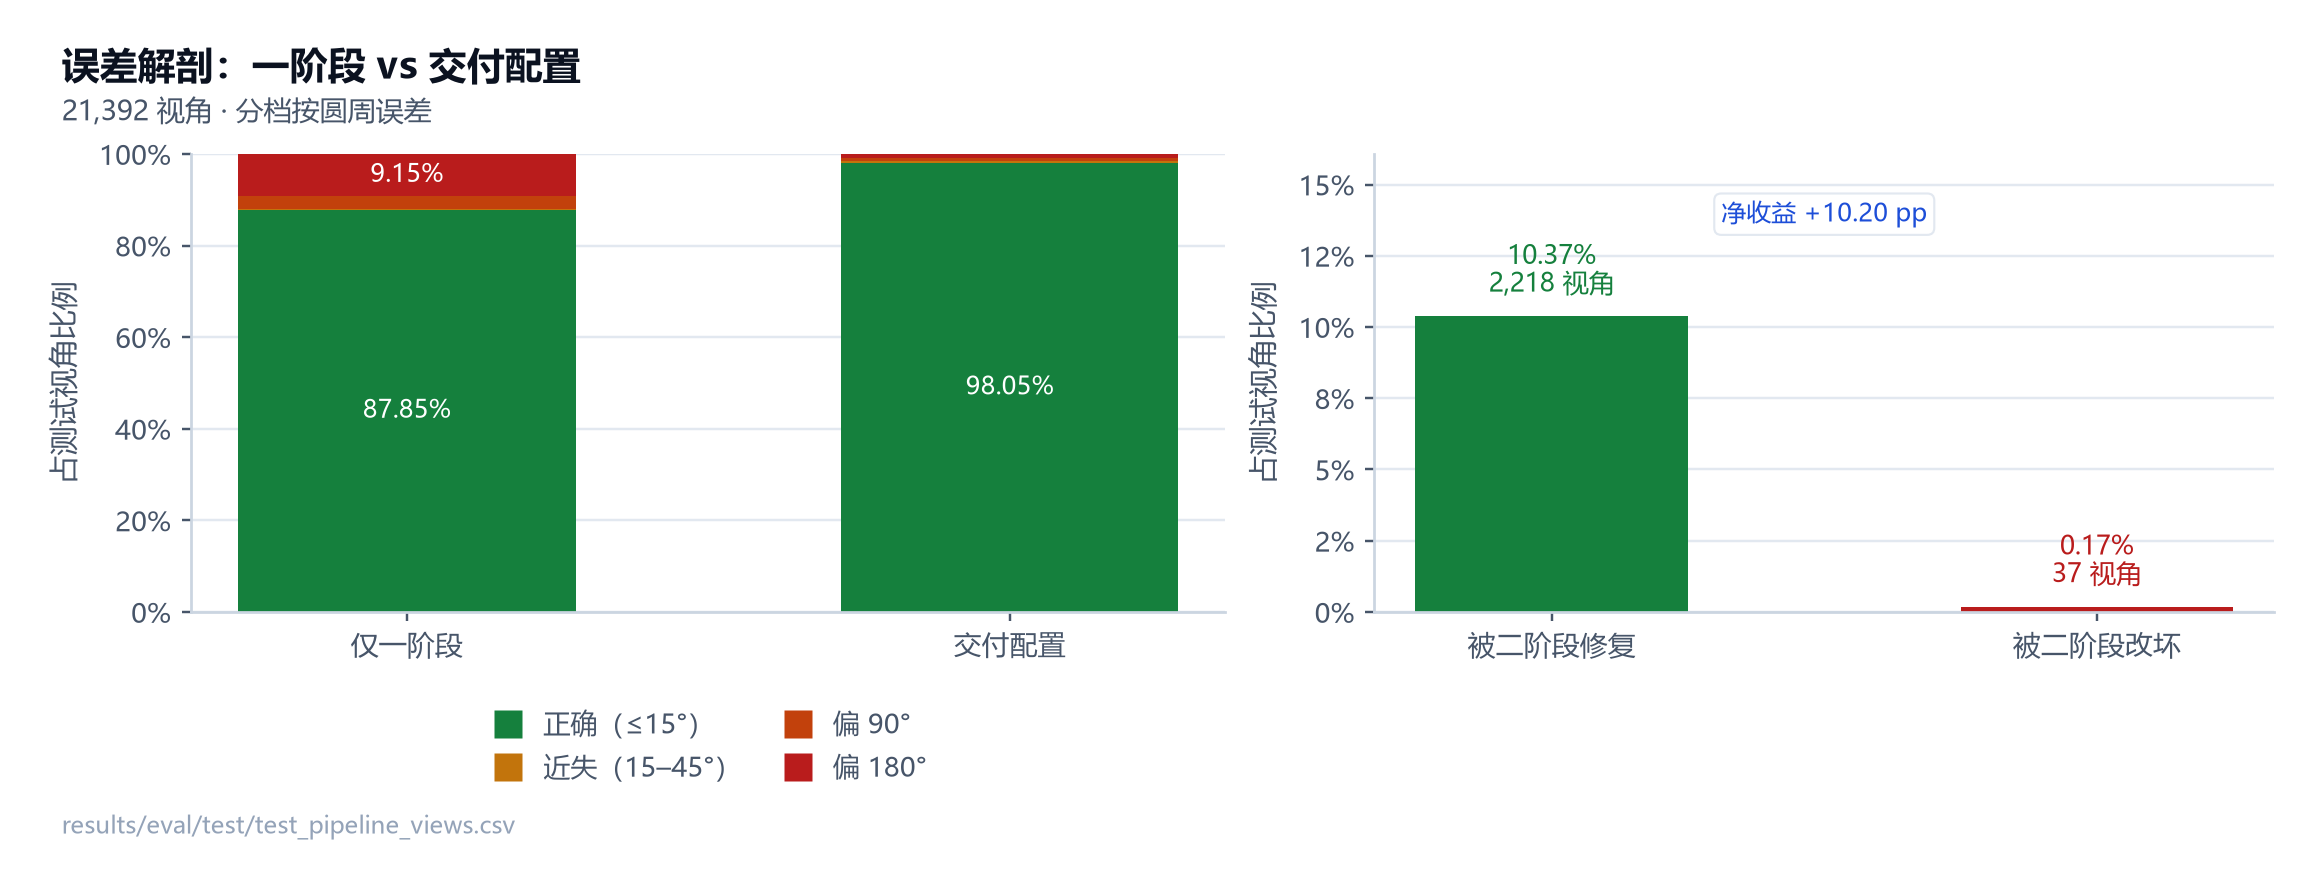
图 14 左图把 21,392 个视角按圆周误差分四档:二阶段把 180° 档从 9.15% 压到 0.87%、90° 档从 2.80% 压到 0.58%。右图是逐视角转移统计——修复 10.37%(2,218 个视角),改坏 0.17%(37 个),净收益 +10.20 pp;在失败档内它修复了 78.8% 的 90° 视角与 89.3% 的 180° 视角。
这张图把误差按档分开,读法是先看左栏的构成、再看右栏的净值:一阶段的错误几乎全部落在 90° 与 180° 两档,15° 量级的相邻类混淆很少;交付配置把 180° 档从 9.15% 压到 0.87%、90° 档从 2.80% 压到 0.58%。右栏的净值说明这不是"用改坏换修好"——逐视角统计下修复 10.37%(2,218 个视角)、改坏 0.17%(37 个视角),净收益 10.20 pp;在失败档内部,它修复了 78.8% 的 90° 视角(n=598)与 89.3% 的 180° 视角(n=1,957)。
这两个修复率(78.8% 与 89.3%)低于"几乎全量改判"时的水平,原因在门控而不是解析器:阈值 0.65 只让 81.10% 的测试视角进入改判,被挡在门外的样本里既有误翻、也有本可修复的真错误。换言之,交付点是用覆盖率换精度——改坏被压到 0.17%(37 个视角),代价是放弃一部分可修复样本;7.5 节的扫描曲线把这条取舍的两端都画了出来。
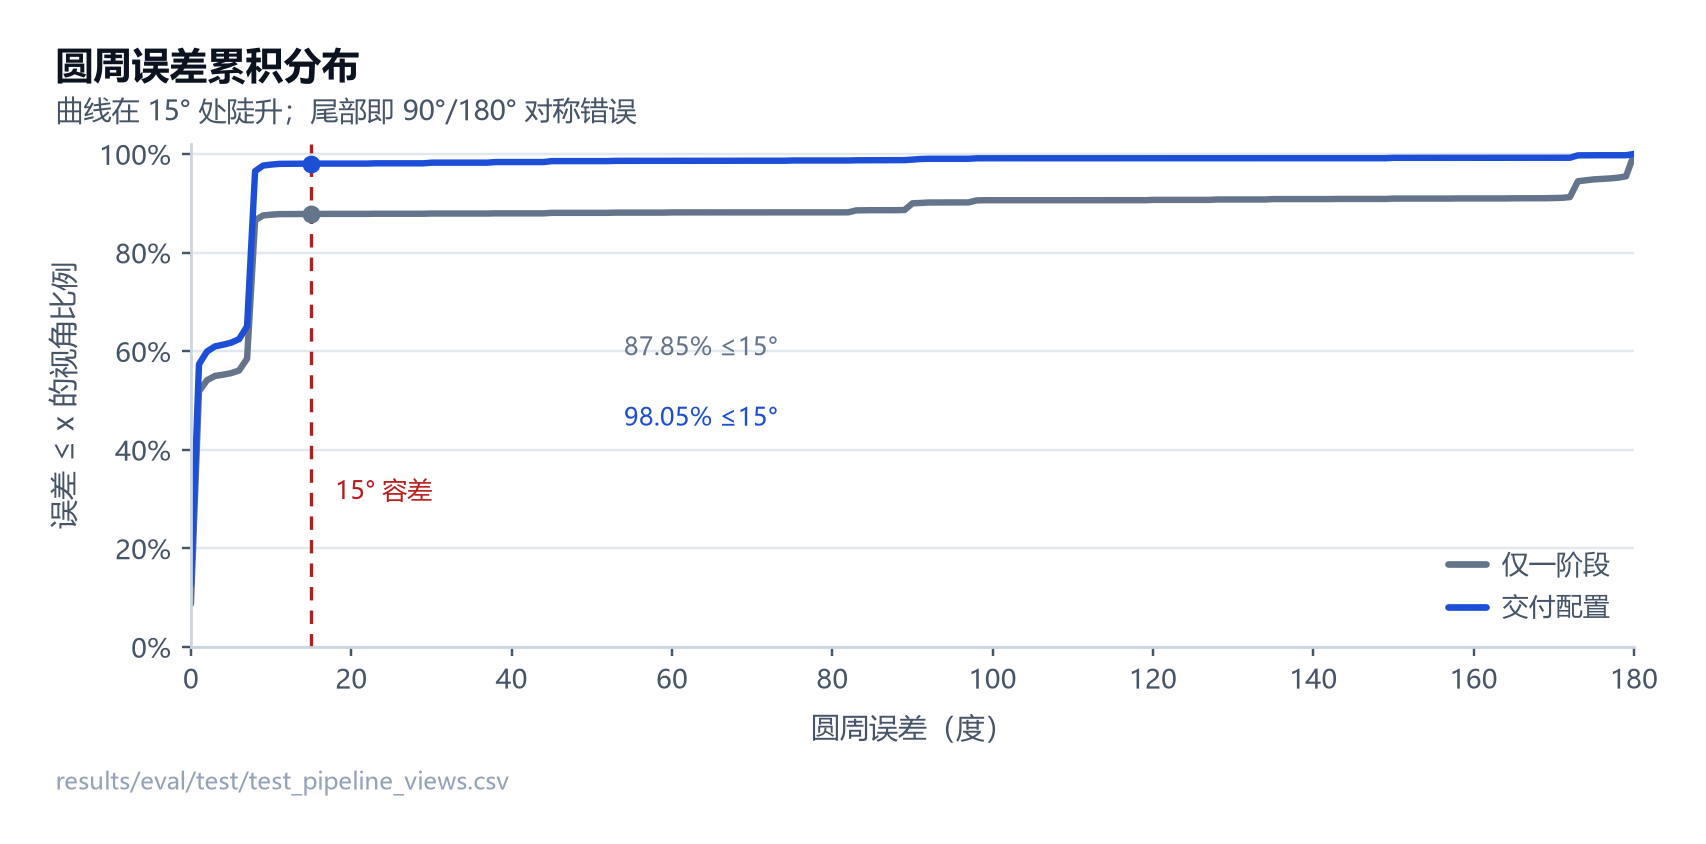
图 15 横轴为圆周误差、纵轴为误差不超过该值的视角比例。两条曲线都在 15° 处陡升,二阶段把 ≤15° 的比例从 87.85% 抬到 98.05%,并把 90°–180° 的尾部显著压低;曲线在 90° 之后的残余部分正是 severe90 的来源。
累积分布图更适合看尾部:交付配置把"误差 ≤15°"的比例从 87.85% 抬到 98.05%,并把 90°–180° 的区间明显压低——被修正的样本大多回到了容差内,而不是被推到 60° 这样的中间地带;曲线在 90° 之后的残余部分正是 severe90 的来源。
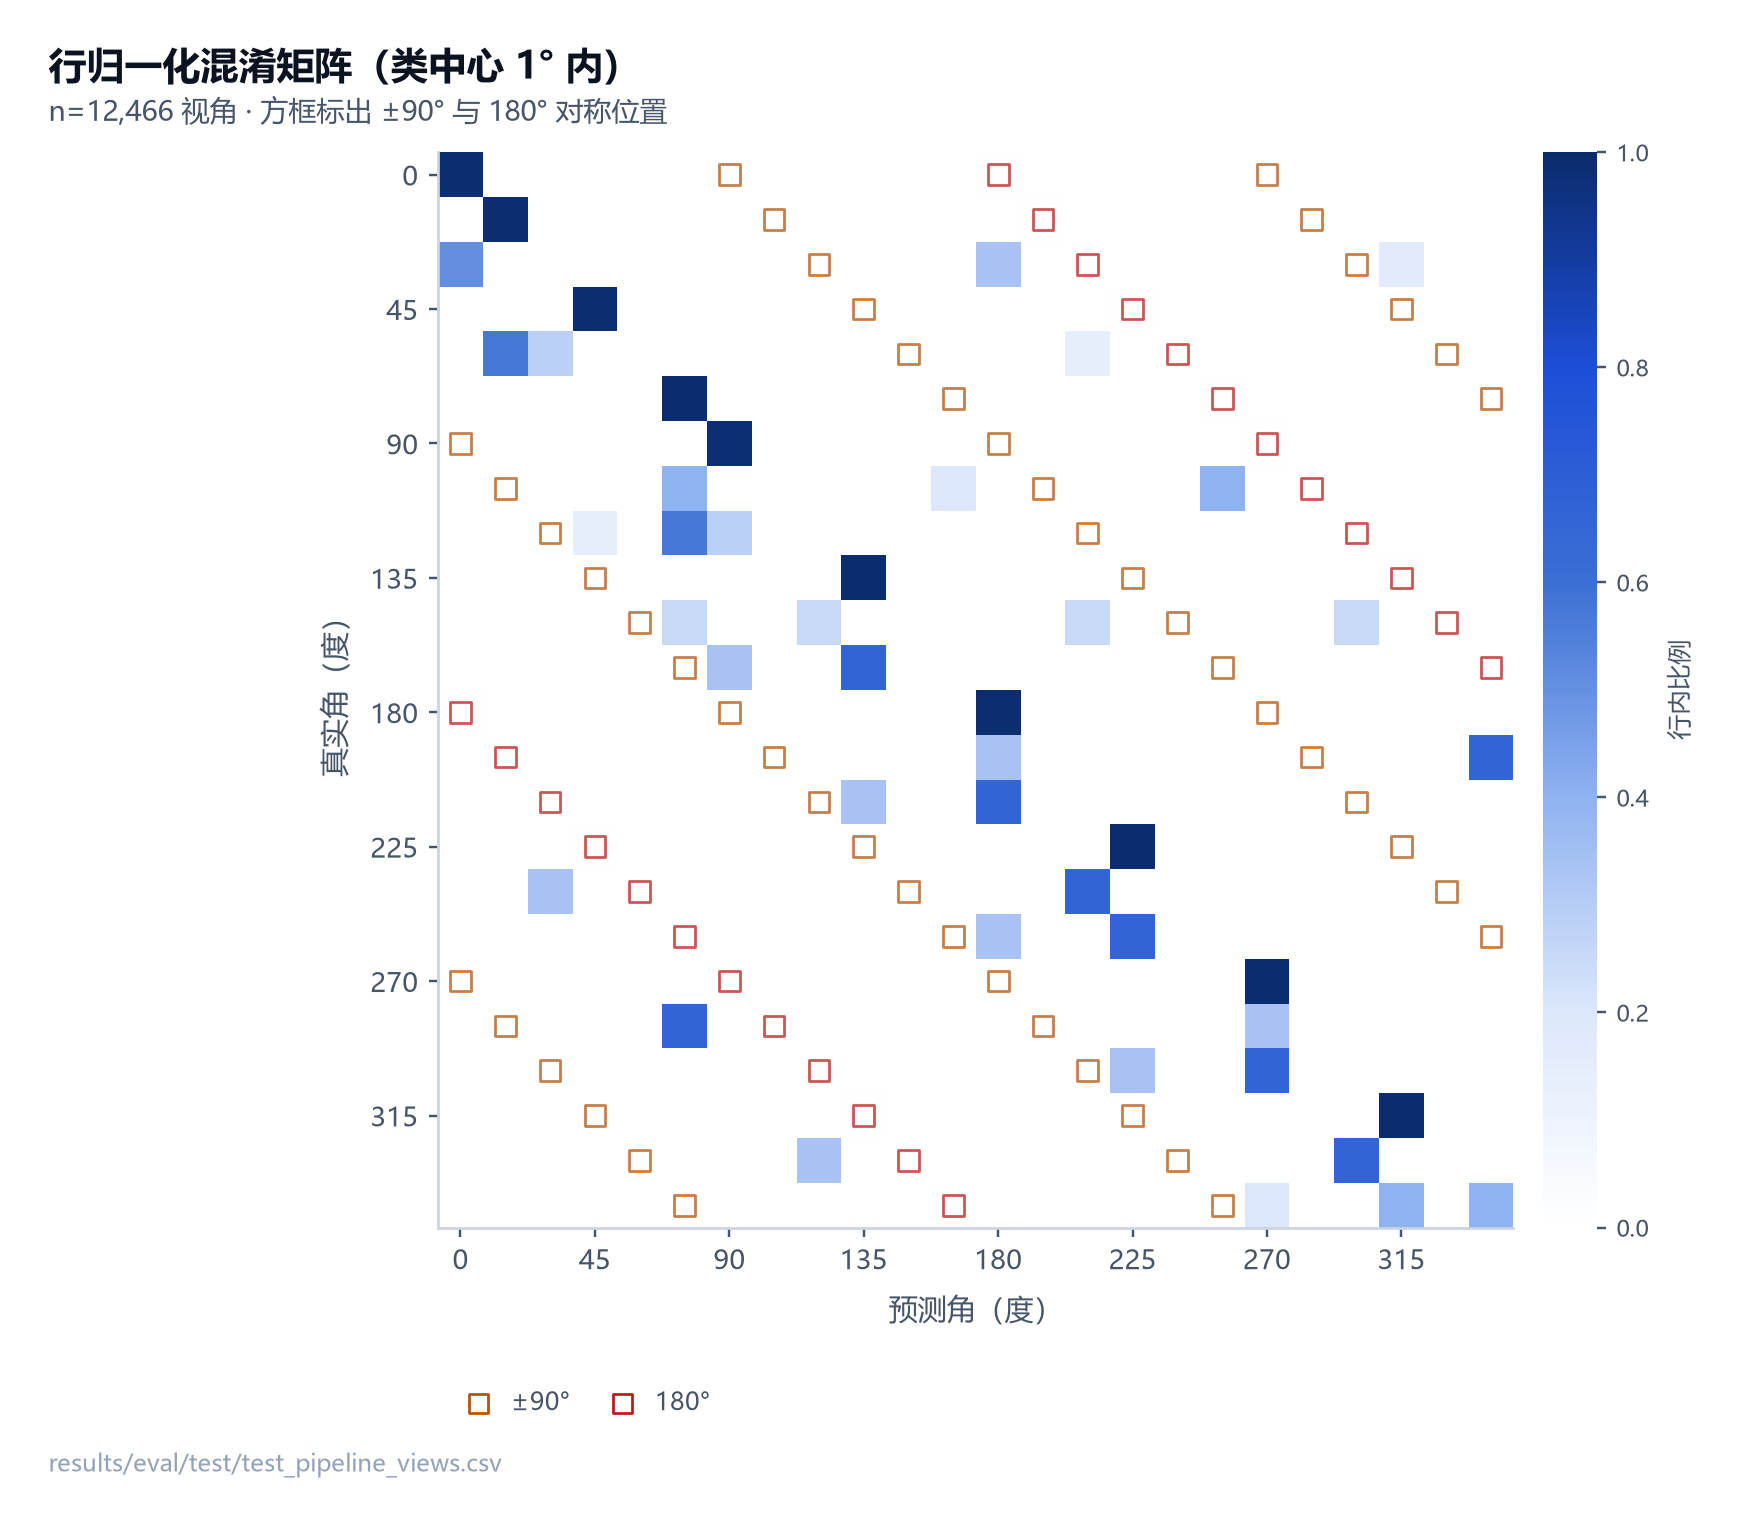
图 16 类中心 1° 以内的 12,466 个视角的行归一化混淆矩阵。对角占绝对主导,非对角质量几乎全部落在 ±90°(橙框)与 180°(红框)两条副对角线上,15° 量级的相邻类混淆极少——这正是四方向解析器能够针对性修复、而细倾角必须留给一阶段的原因。
混淆矩阵按行归一化,只统计距类中心 1° 以内的 12,466 个视角。读图时只需看两条副对角线:非对角质量几乎全部落在 ±90° 与 180° 上,相邻 15° 格的串扰极少。这解释了为什么"24 类 + 四方向复核"的拆分是合理的——残余误差刚好落在解析器的输出空间里,而不在它的盲区里。
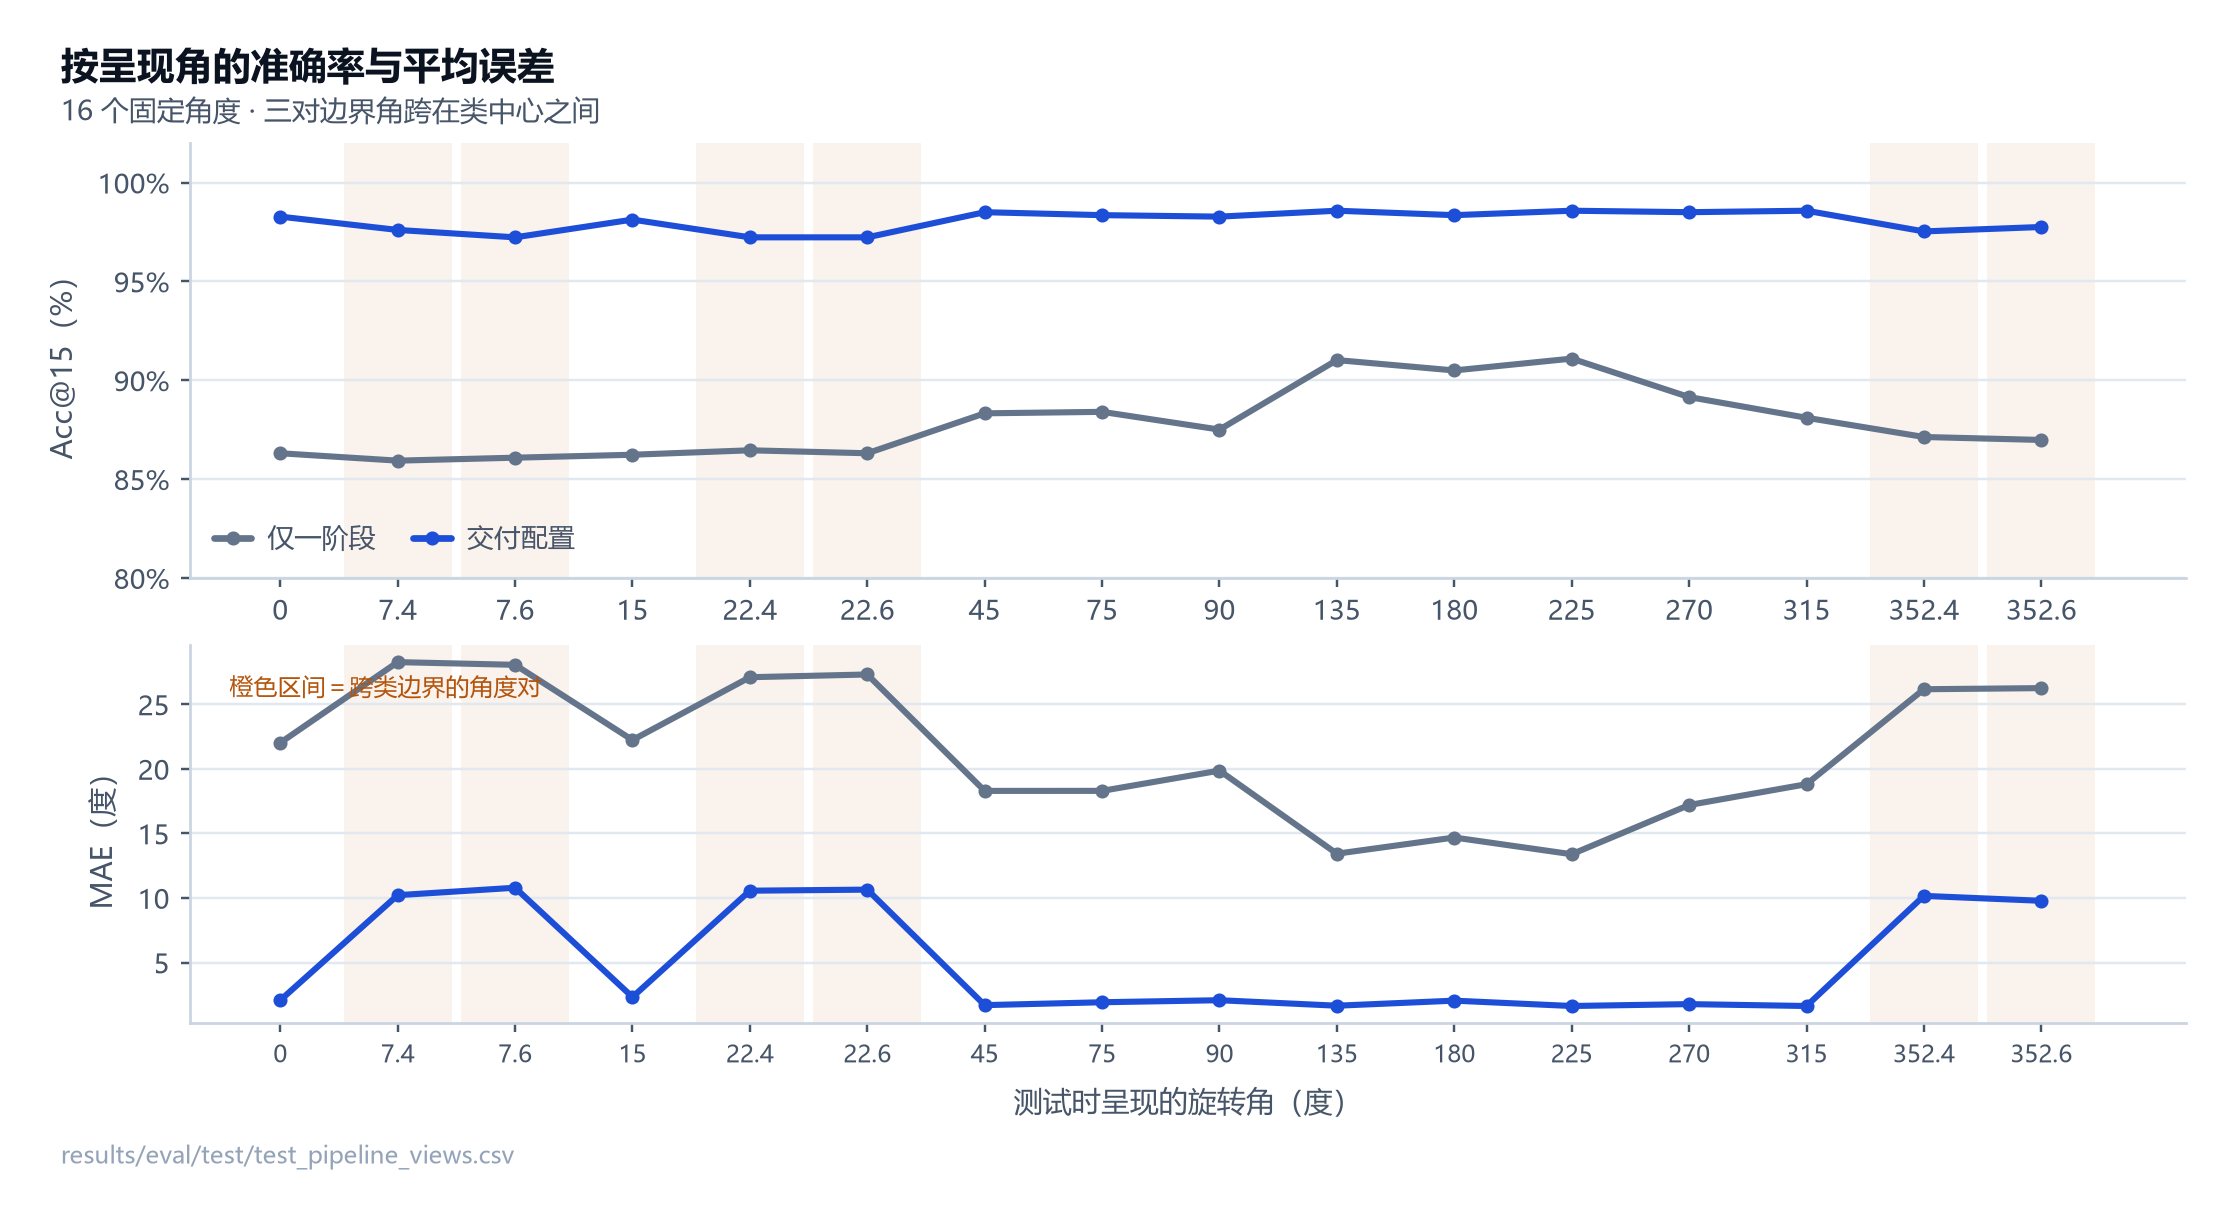
图 17 横轴为测试时施加的 16 个旋转角,橙色区间标出三对跨类边界的角度(7.4/7.6、22.4/22.6、352.4/352.6)。MAE 在这些边界角上明显抬升,而二阶段在每一对上都同时降低误差——说明它修正的是 90° 对称混淆,而不是押中某一侧。
按呈现角拆分时要配合 3.3 节的角度表看:三对跨边界角是设计上的难点位置,若某一侧被系统性押中,成对角的两根柱会明显不对称。读图时应把注意力放在成对角的对称性上,而不是单个角的高低;MAE 在边界角上整体抬升,说明边界抖动是真实存在的误差来源,只是它不严重。
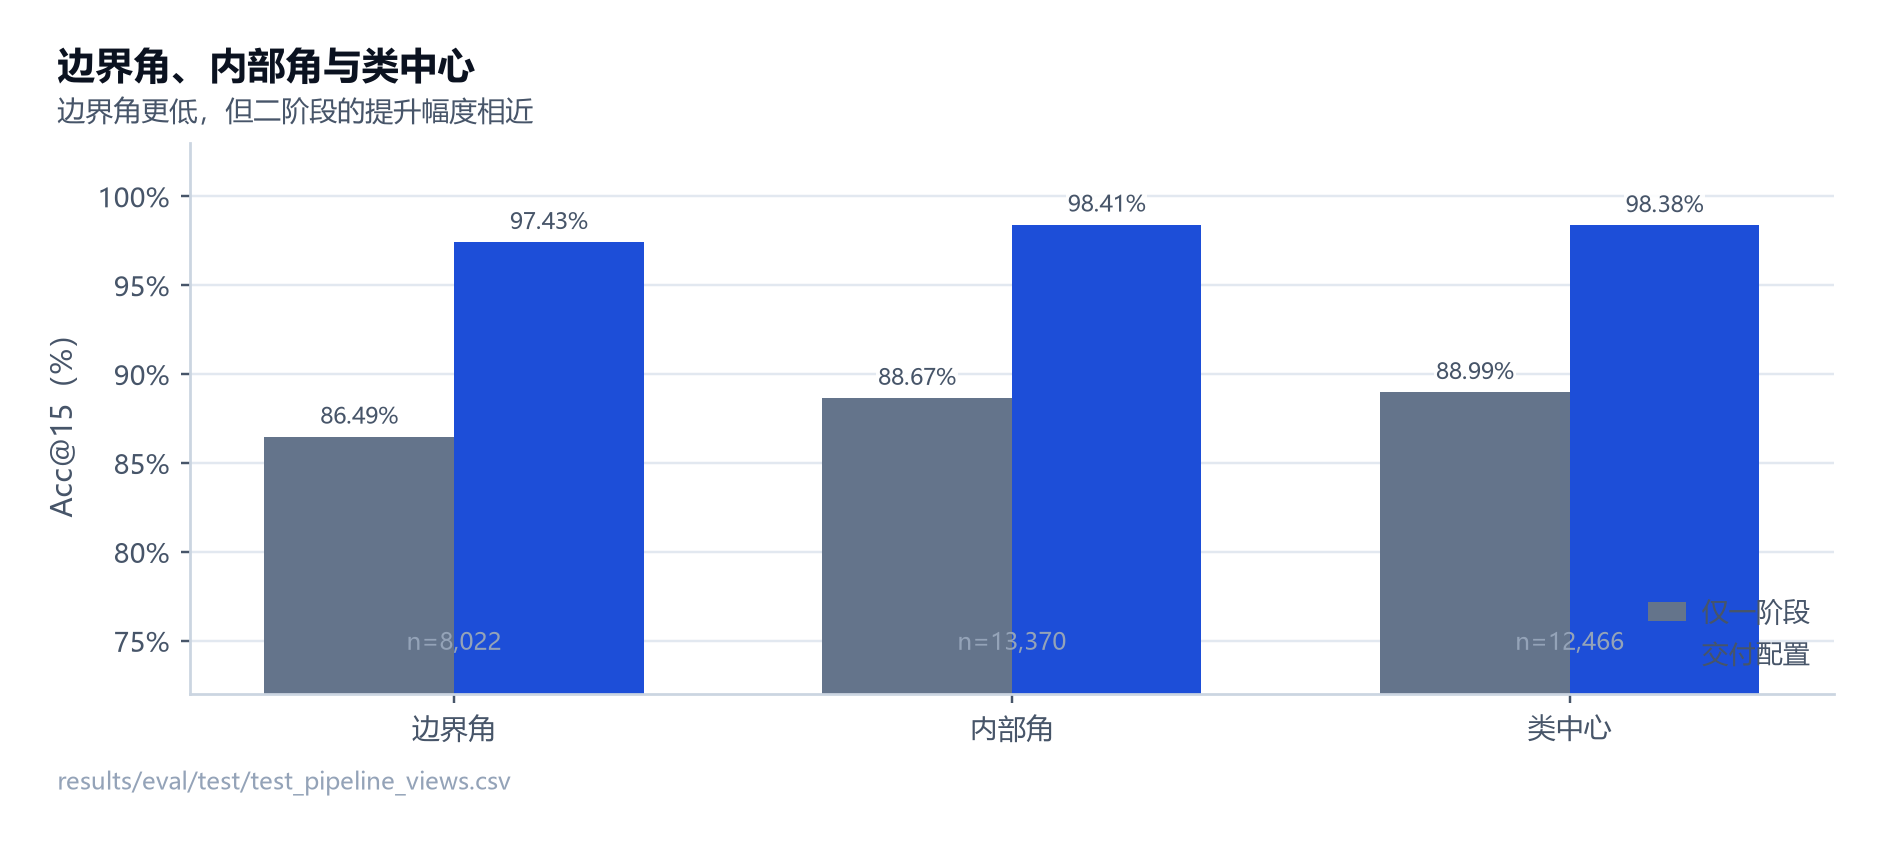
图 18 把测试视角分成跨边界的 8,022 个、内部 13,370 个与类中心 12,466 个。边界角整体更低,但二阶段在三类切片上的提升幅度相近,说明增益不依赖于角度是否恰好落在类中心。
读图时应看两组柱的落差是否随配置收窄:落差没有收窄,因为内部角先饱和、边界角受类边界抖动限制,剩余误差更难消;三者的增益幅度接近,说明改进不依赖角度是否落在类中心。这也解释了为什么再往下压 severe90 比把 Acc@15 从 95% 推到 97% 更难。
表 6 角度切片(测试)
| 切片 | 视角数 | 一阶段 Acc@15 | 交付 Acc@15 |
|---|---|---|---|
| 边界角(7.4/7.6、22.4/22.6、352.4/352.6) | 8,022 | 86.49% | 97.43% |
| 内部角 | 13,370 | 88.67% | 98.41% |
| 类中心(±1°) | 12,466 | 88.99% | 98.38% |
读表要点:交付配置下边界角是三者中最低的切片(97.43%),比内部角低 0.98 pp;三个切片的增益分别是 10.94 pp(边界)、9.74 pp(内部)与 9.39 pp(类中心),彼此接近——说明增益不依赖于角度是否恰好落在类中心,它修的是整数倍混淆而不是边界抖动。
7.5 阈值敏感性
本节回答:唯一的超参数是否被挑到了最优点,还是落在平台中部。
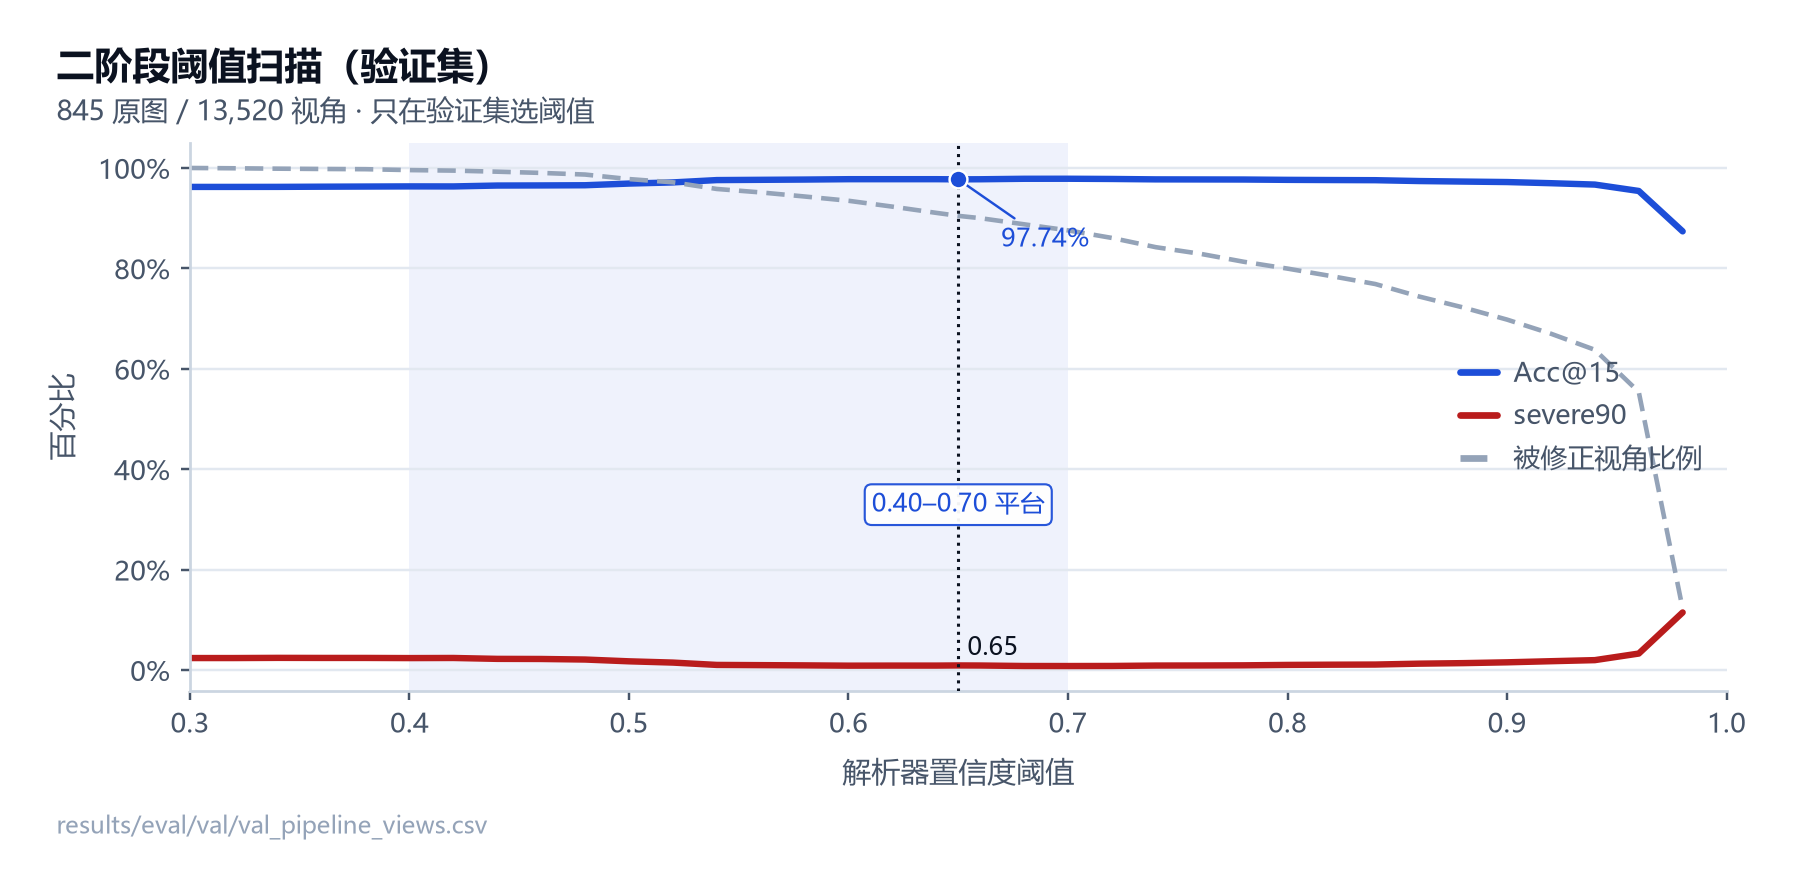
图 19 唯一超参数是施加偏移所需的置信度。0.40–0.70 是一段宽平台(Acc@15 96.32–97.86%、severe90 0.81–2.41%):平台内严重错误率随阈值单调下降,而真修复尚未被误拒。交付点取 0.65,验证集上 Acc@15 97.74%、severe90 0.92%、修正覆盖 90.47%;该点在任何测试视角被评分之前就已固定。阈值超过 0.75 后开始误拒真修复,severe90 回升。
二阶段的唯一超参数就是应用偏移所需的置信度。在验证集(845 张原图 / 13,520 个视角)上扫描后可以看到一段很宽的平台:阈值在 0.40–0.70 区间内 Acc@15 维持在 96.32%–97.86%、severe90 在 0.81%–2.41%;选定值 0.65 对应验证集 Acc@15 97.74%、severe90 0.92%、解析器生效覆盖率 90.47%,测试集同一点为 Acc@15 98.05%、severe90 1.21%。
为什么是 0.65 而不是更高或更低。往下看:阈值降到 0.50 时几乎全量改判(覆盖率 97.79%),误翻因此进入结果,severe90 升到 1.75%;往上抬一格到 0.60 就把这两项改善到 97.77% / 0.88%。往上再看:0.70 给出 97.86% / 0.81%,但它相对 0.65 的差别只有 0.12 pp 的 Acc@15 与 0.11 pp 的 severe90,落在 13,520 个验证视角的抽样噪声之内,而覆盖率低 2.90 pp——更高的门控是靠少改判换来那点验证集差异的,代价是放弃一部分本可修复的真错误。继续抬高则明确变差:0.80 时覆盖率 79.96%、severe90 回到 1.03%,0.90 时 69.80% / 1.55%,0.96 之后急剧恶化(Acc@15 95.42%、severe90 3.29%),0.98 时几乎不再修正(覆盖率 12.21%、Acc@15 87.37%、severe90 11.48%)。因此 0.65 是"压掉误翻"与"保住真修复"之间的折中,落在平台内部而不是边缘;整条曲线是在验证集上选点、在测试集上验证的一次性流程,不是拿测试集调参。
7.6 效率
本节回答:精度换来了多少计算成本,这笔成本在什么维度上增长。
表 7 体积与延迟(4 线程,1025×1025 页面,纯 CPU)
| 配置 | 参数 | 端到端中位数(ms) | fp32 权重 |
|---|---|---|---|
| 仅一阶段(24 类集成 + TTA4) | 264,034 | 27.3 | 1.06 MB |
| 一阶段 + 四方向二阶段(交付) | 385,620 | 57.4 | 1.54 MB |
| 二阶段增量 | 121,586 | 30.1 | 0.49 MB |
注:fp32 体积按「参数量 × 4 字节 / 10⁶」换算,交付配置的 1.54 MB 是产物记录值,其余两行按同一换算式得出;增量行为前两行之差。延迟协议为 2 次预热后 4 轮交错测量、每轮 15 次计时,取各轮均值的中位数。
读表要点:按参数与延迟看,最优值都在最轻的配置上,这不奇怪——交付配置用 121,586 个额外参数与 30.1 ms 的二阶段增量,换来 Acc@15 从 87.85% 到 98.05%。这笔交换在 7.1 节的配对区间里是有界的,不是"用算力换精度"的模糊说法。二阶段只在 5 个 256 px 裁剪上跑,成本与页面原尺寸无关,因此在大页面上它的相对占比被压得很低。
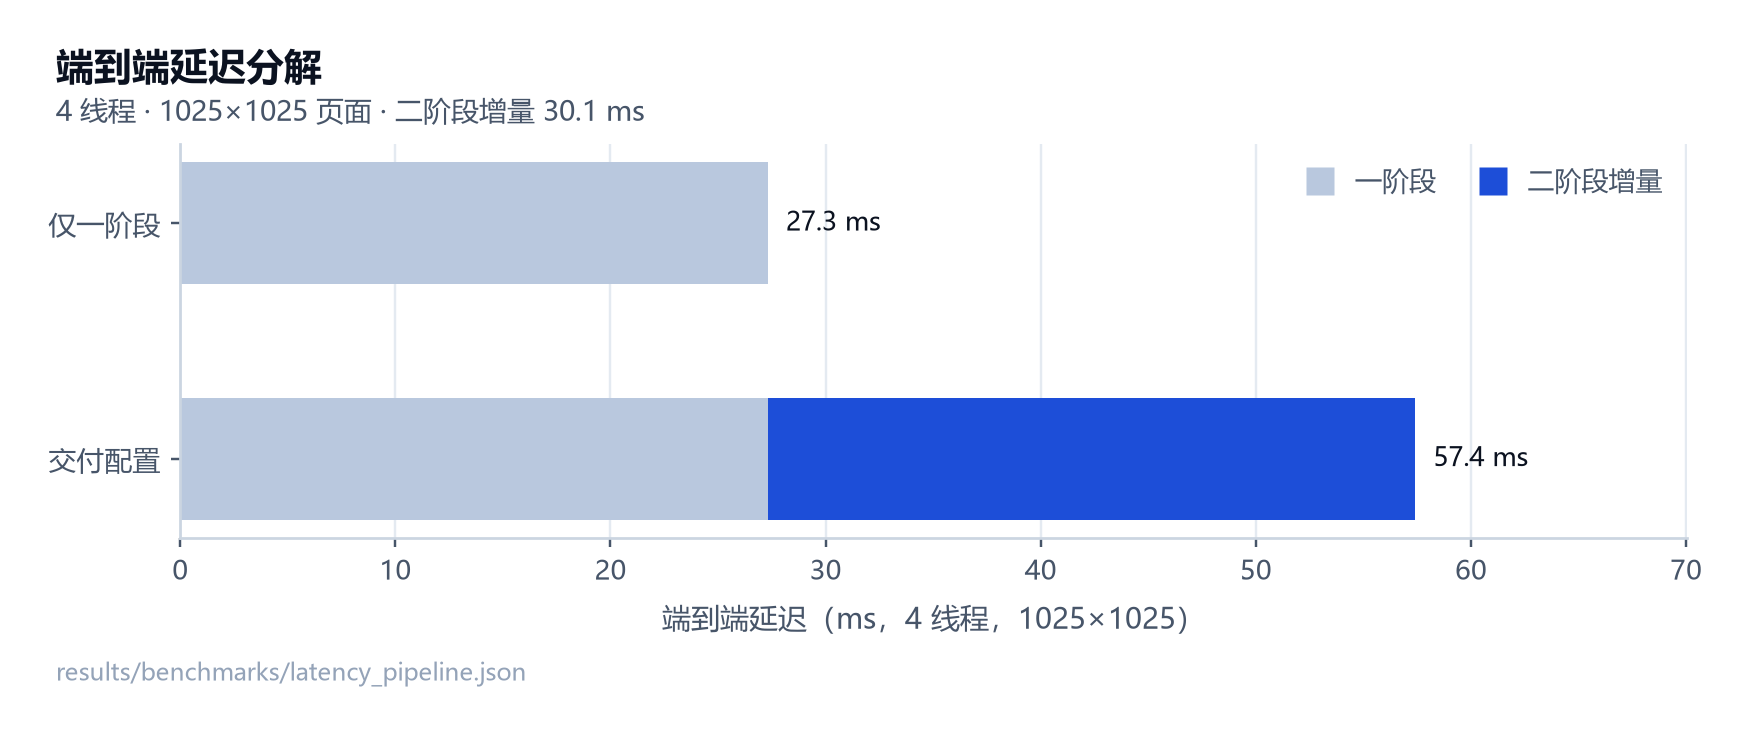
图 20 浅色为一阶段(两次网络前向 × 4 向 TTA),深色为二阶段增量。四方向解析器只跑 5 个裁剪,因此把 24 类预测细化到 90° 级的残余偏移只多花 30.1 ms(27.3 → 57.4 ms)。
读图时看的是分解后的两段而不是总高度:一阶段那一段在两个配置里完全相同,差异全部来自二阶段;四方向解析器把 24 类预测细化到 90° 级的残余偏移,只多花 30.1 ms(27.3 → 57.4 ms)。
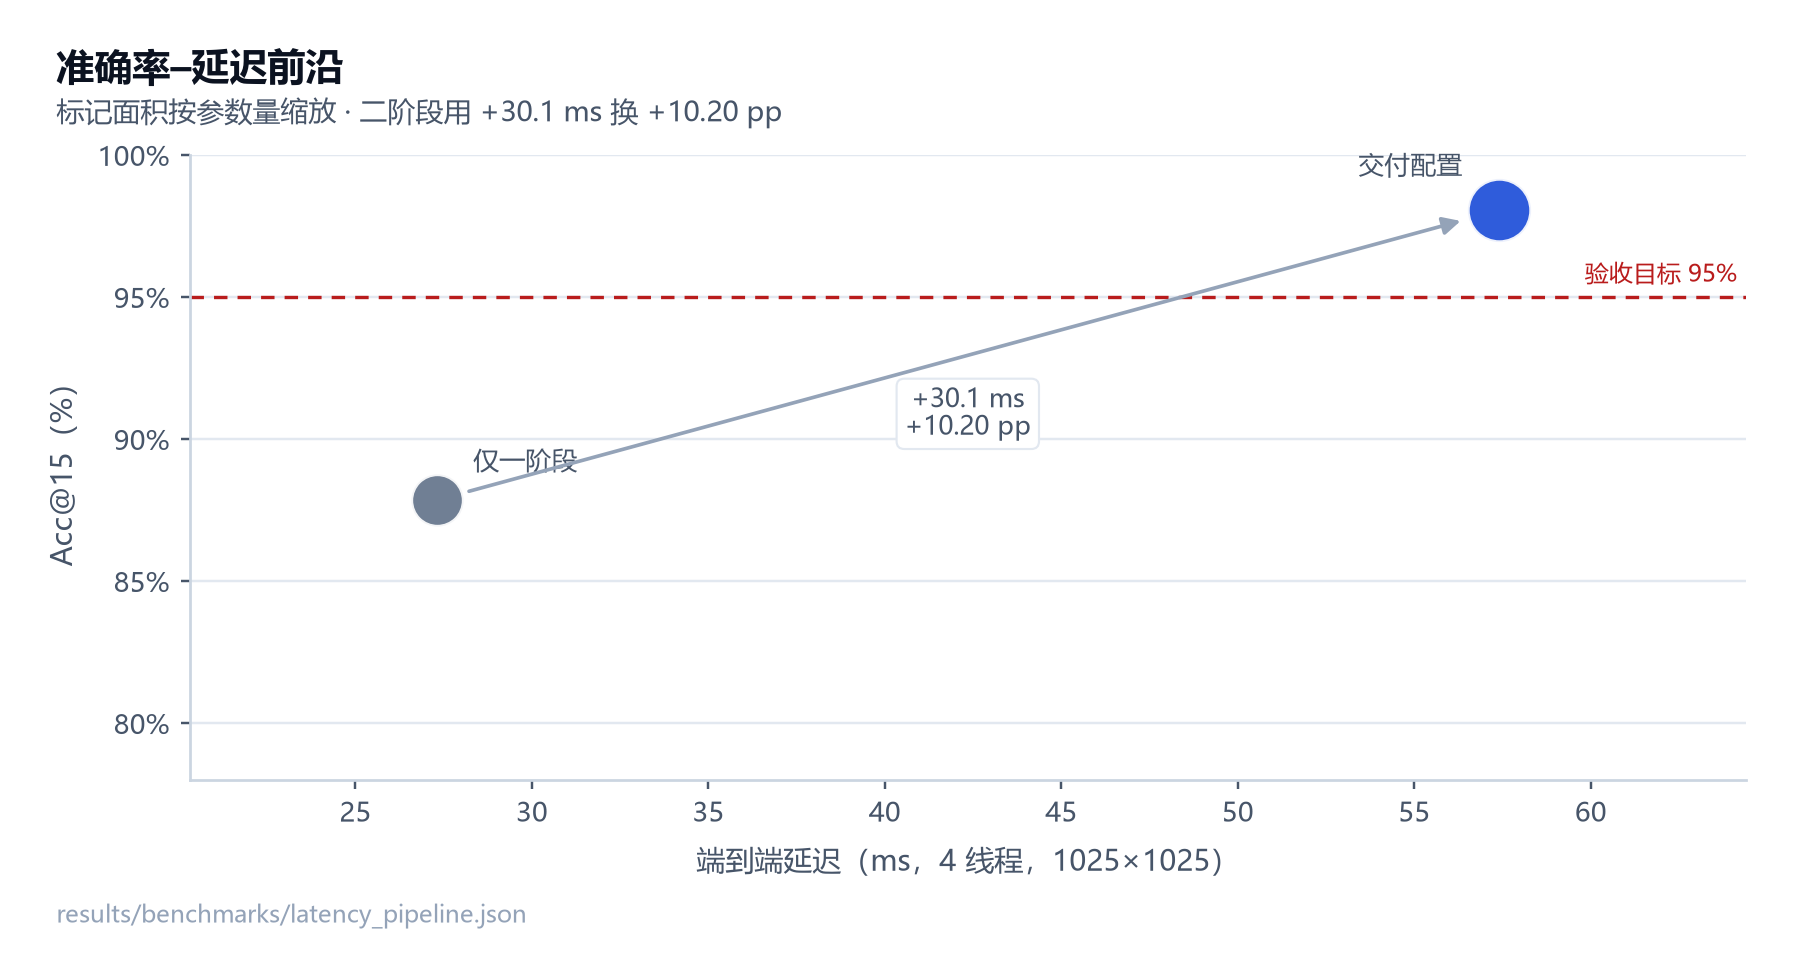
图 21 两种配置放在同一平面上,标记面积按参数量缩放。二阶段用 30.1 ms 换到 10.20 pp 的 Acc@15 与 10.10 pp 的 severe90 改善,是本设计里投入产出最明显的一步。
准确率–延迟前沿上只有两个点,结论却很直接:交付配置更准也更慢,没有任何配置同时做到更准且更快,因此它买到的是 10.20 pp 的 Acc@15 与 10.10 pp 的 severe90 改善,而不是一个更好看的单一数字。
8 讨论
本节回答:为什么这套分解有效、残余误差是什么性质、哪些结论不稳、下一轮该往哪走。
为什么把 24 路决策拆成"24 路 + 4 路"有效。 两个子问题需要的信息类型不同:15° 量级的倾斜需要全局版面与文字行的走向,0/90/180/270 的对称混淆主要依赖局部字形的上下缘。一阶段必须在整图上同时兼顾两者;二阶段则在正立化后的局部裁剪上只回答一个四选一问题,输入里已没有页面朝向这类干扰。混淆矩阵的结构支持这一分解——残余误差几乎只落在 ±90° 与 180° 两条副对角线上,而这两条恰好是四方向解析器的输出空间。这一"把结构写进输出空间"的思路与选择性预测、校准两条文献线索相接:前者关心何时该拒绝作答 [24],本文关心何时该改判;后者提醒置信度本身不可直接解释 [25],本文用验证集上的平台宽度而不是名义置信度来界定工作点。
残余误差的性质。 剩余的 1.21% 集中在两处。其一是 scene_text 的残差(severe90 3.17%),主要来自单词级紧裁切图:这类输入本身的方向信息就稀薄。其二是 documents 的严重误差(severe90 1.04%,但该域 off90 与 off180 都是 0),说明这些视角的误差落在整数倍之间,四方向解析器在原理上无法修正——它只能平移 90° 的整数倍。两者的共同点是"信息不足",而不是"容量不足",因此下一轮工作应先补这类难例与相应评测,而不是换更大的骨干。这一判断也与本文的消融一致:从一阶段到交付配置的全部收益来自结构,而不是参数量。
门控是一个能同时改善两项指标的自由度。 扫描曲线显示出一处不对称:从 0.50 抬到 0.65,Acc@15 与 severe90 同时改善(96.89% / 1.75% → 97.74% / 0.92%),两项因此并不构成零和。合理解释在于误翻与真修复的置信度分布不同——误翻更多落在阈值上方不远处,真修复通常伴随更高的置信度——所以抬高门控先削掉误翻、后伤到真修复。越过平台后这种不对称反转:0.80 起覆盖率降到 79.96%、severe90 回到 1.03%,两项指标一起变差。这解释了为什么阈值必须落在平台内,也解释了为什么 0.65 附近相邻点之间的差别不能当作信号。
阈值的过拟合风险。 二阶段的规则与阈值在验证集上选定,且在验证集上比较过多个候选策略。三道防线是:阈值只在验证集选定、测试集只跑一次、以及 7.5 节的平台宽度。但它们不能完全排除少量乐观偏差:验证集只有 845 张原图,一个百分点的差别在其中只对应一百多个视角。因此测试集数字应读作"这套权重在这份留出集上的一次测量",而不是"真实精度"。同理,本文报告的全部区间都是关于"这批原图"的抽样不确定性,不包含分布漂移。
与文献的关系。 本文的方法处在两条线索的交点上:几何显式化的学习式流水线(如文档去畸变一类工作 [13,14])与轻量的选择性复核(如带拒识的分类 [24])。区别在于本文把"复核"的决策空间从二值推广到四个整数倍,并把成本压在 CPU 可实时的量级——这一点与当下以大规模预训练换取通用性的路线 [15,30] 不同,本文的取舍是"把问题结构写清楚,而不是把模型做大"。
9 局限与合规
本节回答:这份报告在哪些条件下成立,哪些风险没有被评测覆盖。
- 旋转是合成的。 21,392 个测试视角由 1,337 张原图精确旋转得到,标签因此无噪声;语料中真实的非基数倾斜很少,真实相机滚转、透视与运动模糊的多样性被明显低估,现场精度会低于报告值。
- 标签没有人工全量审计。 基标签来自三路自动融合,VLM 自报置信度未经校准;83 张留在 review 的原图被排除,74 张仅用投影剖面的标签没有第二路交叉校验。替代证据是受控旋转审计(MAE 12.24°、p90 6.49°)、正立化视觉抽检与多路一致性,三者都不是人工双盲审计。
- 测试集与训练同源。 它是按原图层面划分的留出集,不是外部基准;没有第三方重标数据,也没有跨设备、跨语种的独立测试集。它衡量的是"同一批来源上的泛化"。
- 一个域没过 95%。 scene_text 的 Acc@15 为 94.27%(最弱)、severe90 3.17%;documents 已过线(98.96%),severe90 1.04%,且只有 48 张测试原图 / 768 个视角;tables_forms 也只有 50 张 / 800 个视角。小样本域的分域 severe90 应视为指示性数值。
- severe90 仍高于目标,但差距已收窄。 实测 1.21%,目标 ≤1%,两者相差 0.21 pp;差距比 Acc@15 那一侧小得多,却仍是一条未跨过的线——本文所有结论都在"未通过 severe90 门槛"的前提下成立。
- 解析器的修正空间有限。 四方向解析器只能施加 90° 的整数倍偏移,因此落在整数倍之间的严重误差(如 documents 的那部分)在原理上不可修;要压低这类错误只能回到一阶段的细粒度能力或补相应难例。
- 训练预算与语料规模绑定。 每个一阶段网络把 7,906 张训练原图过了约 205 遍(30 轮 × 54,000 个采样视图 = 1.62M 个样本);这个预算与语料规模是一起定的,将来扩大语料时必须同步放大采样视图数,否则同样的 30 轮会退化成欠训练。
- 混合方向与无文字图像未建模。 系统对任何输入都会给出一个全局角度;竖排文字、多方向混排与几乎无文字的图片应由下游拒识。清单中
mixed_direction=true的样本只有 1 张,这一场景没有被评测覆盖。 - 合规与数据再分发。 标注阶段的 VLM 通过 OpenAI 兼容端点调用,图像像素离开本机,因此本轮只处理公开研究数据集;FUNSD 仅限非商业研究与教学用途、RICO 带研究用途义务、DocLayNet 遵循上游 CDLA-Permissive-1.0,仓库只发布清单、指纹与指标,不重新分发任何第三方图像,逐来源许可见附录 C。
10 结论
本节回答:这套系统交付了什么,明确的边界在哪里。
本文把文本方向检测写成圆周上的 24 类判定,并在其后接一级四方向残余偏移解析器。两级的接口是一个显式的几何式:一阶段给出 ,二阶段给出 ,输出 。在 1,337 张留出原图 × 16 个固定角度的 21,392 个视角上,交付配置达到 Acc@15 98.05%(95% CI 97.36–98.65)、severe90 1.21%、MAE 5.06°、宏 Acc@15 98.50%,端到端 57.4 ms、385,620 参数、fp32 1.54 MB,纯 CPU。同一批视角上,去掉二阶段的配置为 Acc@15 87.85%、severe90 11.31%,配对提升 10.20 pp(8.80–11.61)。
结论有两条边界。其一,验收门槛只通过一半:宏平均 Acc@15 98.50% 达标,severe90 1.21% 未达 1% 的目标,因此本系统不宣称通过验收。其二,全部分数是同源留出集上的一次测量,旋转是合成的,标签未经人工全量审计,真实拍摄条件下的表现需要独立评测才能确认。能带走的稳定结论是方法层面的:把"方向"的离散对称结构写进输出空间与流水线的接口,比把它留给分类器在特征里自行编码更可靠——残余误差的分布(几乎只落在 ±90° 与 180°)与解析器的输出空间恰好重合,这不是巧合,而是设计的结果。
参考文献
- R. O. Duda, P. E. Hart. Use of the Hough transformation to detect lines and curves in pictures. Communications of the ACM, 1972.
- W. Postl. Detection of linear oblique structures and skew scan in digitized documents. ICPR, 1986.
- H. S. Baird. The skew angle of printed documents. SPSE Symposium on Hybrid Imaging Systems, 1987.
- D. X. Le, G. R. Thoma, H. Wechsler. Automated page orientation and skew angle detection for binary document images. Pattern Recognition, 1994.
- R. Smith. An overview of the Tesseract OCR engine. ICDAR, 2007.
- G. Jaume, H. K. Ekenel, J.-P. Thiran. FUNSD: A dataset for form understanding in noisy scanned documents. ICDAR Workshops, 2019.
- S. Park, S. Shin, B. Lee, et al. CORD: A consolidated receipt dataset for post-OCR parsing. NeurIPS Workshop on Document Intelligence, 2019.
- Z. Huang, K. Chen, J. He, et al. ICDAR2019 competition on scanned receipt OCR and information extraction (SROIE). ICDAR, 2019.
- B. Pfitzmann, C. Auer, M. Dolfi, et al. DocLayNet: A large human-annotated dataset for document-layout segmentation. KDD, 2022.
- B. Deka, Z. Huang, C. Franzen, et al. Rico: A mobile app dataset for building data-driven design applications. UIST, 2017.
- A. Singh, G. Pang, M. Toh, et al. TextOCR: Towards large-scale end-to-end reasoning for arbitrary-shaped scene text. CVPR, 2021.
- B. Wang, G. Li, X. Zhou, et al. Screen2Words: Automatic mobile UI summarization with multimodal learning. UIST, 2021.
- K. Ma, Z. Shu, X. Bai, et al. DocUNet: Document image unwarping via a stacked U-Net. CVPR, 2018.
- S. Das, K. Ma, Z. Shu, et al. DewarpNet: Single-image document unwarping with stacked 3D and 2D regression networks. ICCV, 2019.
- Y. Huang, T. Lv, L. Cui, et al. LayoutLMv3: Pre-training for document AI with unified text and image masking. ACM Multimedia, 2022.
- J. Hu, L. Shen, G. Sun. Squeeze-and-excitation networks. CVPR, 2018.
- F. Chollet. Xception: Deep learning with depthwise separable convolutions. CVPR, 2017.
- S. Ioffe, C. Szegedy. Batch normalization: Accelerating deep network training by reducing internal covariate shift. ICML, 2015.
- I. Loshchilov, F. Hutter. SGDR: Stochastic gradient descent with warm restarts. ICLR, 2017.
- I. Loshchilov, F. Hutter. Decoupled weight decay regularization. ICLR, 2019.
- R. Müller, S. Kornblith, G. Hinton. When does label smoothing help? NeurIPS, 2019.
- B. Lakshminarayanan, A. Pritzel, C. Blundell. Simple and scalable predictive uncertainty estimation using deep ensembles. NeurIPS, 2017.
- D. Shanmugam, D. Blalock, G. Balakrishnan, J. Guttag. Better aggregation in test-time augmentation. ICCV, 2021.
- Y. Geifman, R. El-Yaniv. Selective classification for deep neural networks. NeurIPS, 2017.
- C. Guo, G. Pleiss, Y. Sun, K. Weinberger. On calibration of modern neural networks. ICML, 2017.
- B. Efron. Bootstrap methods: another look at the jackknife. The Annals of Statistics, 1979.
- K. V. Mardia, P. E. Jupp. Directional Statistics. Wiley, 2000.
- T. Cohen, M. Welling. Group equivariant convolutional networks. ICML, 2016.
- C. Shorten, T. M. Khoshgoftaar. A survey on image data augmentation for deep learning. Journal of Big Data, 2019.
- L. Deng, D. Yu. Deep learning: methods and applications. Foundations and Trends in Signal Processing, 2014.
附录 A 指标定义
本附录回答:每个数字的分子分母是什么,评测协议如何保证可复现。
全部指标定义在"视角"上,一个视角 = 一张原图 × 一个固定旋转角。Acc@7.5、Acc@15、severe90 是圆周误差落在区间内的视角比例;MAE 是圆周绝对误差的算术均值;宏 Acc@15 是五域 Acc@15 的算术平均。off90 与 off180 不是比例,而是误差正好等于 90°、180° 的视角计数——它们是判断"错误是否集中在整数倍对称上"的机制证据。
severe90 在本文只有一个定义:圆周误差 ≥ 90° 记为严重错误。24 类网格上,误差恰好 90° 对应类别索引相差 6 格,是一个真实存在、且下游完全不可用的状态——一页正好横置的文档与横置 91° 的文档,在 OCR 里的后果相同,因此二者不应被划分到两侧。
评测协议有四个要点。第一,16 个固定角度(0、7.4、7.6、15、22.4、22.6、45、75、90、135、180、225、270、315、352.4、352.6)对每张测试原图各渲染一次,因此视角数恰为原图数 × 16;7.4/7.6 与 22.4/22.6 这类成对角度故意压在类边界两侧,用来测边界抖动。第二,区间用按原图分组的自助法:重采样单元是 group_id,同一张原图的 16 个视角整组进出,2,000 次重采样、种子 20261024、取 2.5/97.5 百分位 [26]。按视角重采样会低估方差,因为同源视角高度相关。第三,配对比较沿用同一分组,两个配置在同一个重采样批次里相减。第四,测试集只跑一次,阈值与规则在此之前已经固定。
产物级交叉核对由 src/extract_metrics.py 每次运行时重做,共五项:重建的旋转落回 16 个角度网格;视角数等于原图数 × 16(21,392 / 1,337);一阶段角度重算能复现产物中的 err_none 列(最大偏差 0.0000°);训练原图与评测集共享像素哈希为 0;清单内部没有原图或像素跨划分(0 处违规)。五项结果逐条写在 METRICS.md 末尾的交叉核对表里。
附录 B 复现命令
本附录回答:要重跑报告里的每一个数字,需要按什么顺序执行哪些命令。
1 | python src/train_stage1.py --config config/stage1_a192.json \ |
顺序有依赖:extract_metrics.py 必须先跑,报告与图都从它产出的 results/canonical/key_numbers.json 与逐视角 dump 重算;make_report_figures.py 在指标之后、build_reports.py 之前。平台版本、随机种子与逐步说明见复现文档。
附录 C 指纹与产物索引
本附录回答:这份报告的数字具体来自哪几个文件,语料指纹是什么。
清单指纹。 发布语料的清单 data/manifest_stage2.csv 共 10,171 行,SHA-256 为
1 | 89b99f022acdda9e74de6b77dc048963d5cadca536893116304bbd4912ab47e7 |
该摘要由 src/extract_metrics.py 在生成 METRICS.md 时对清单文件现算并写入表 A6,同时核对清单行数、approved 计数与划分计数三者一致(10,171 行 / 10,088 approved / 7,906 + 845 + 1,337)。清单行数比 approved 多出的 83 行是 status=review 的记录。
权重指纹(sha256sum 实测,与 results/experiment.json 记录一致;三个文件都在 release/compasstext-24/models/):
1 | compasstext-24-b224.pt 9e43297ec5183261aa2f80cfab7671901c5ff8e4ae8995db83ab97cb8c4b3d0a |
逐来源许可与规模(approved 原图数取自清单;仓库不重新分发任何图像):
- DocLayNet —— documents,797 张;CDLA-Permissive-1.0(上游,研究用途)。
- SROIE —— receipts,971 张;CC-BY-4.0。
- CORD —— receipts,996 张;CC-BY-4.0。
- FUNSD —— tables_forms,199 张;仅限非商业研究与教学用途。
- RICO-Screen2Words —— screens_slides,3,599 张;镜像 CC-BY-4.0,原始 RICO 带研究用途条款。
- TextOCR —— scene_text,3,526 张;镜像 MIT,图像来自 TextOCR / Open Images,上游条款适用。
产物索引(本报告数字的全部上游):
data/manifest_stage2.csv—— 发布清单:路径、哈希、来源、域、划分、group_id、base_angle_deg、base_angle_sigma_deg、label_method。results/eval/test/test_pipeline_views.csv—— 21,392 个测试视角的逐视角 dump(group_id、domain、truth_deg、theta、err_none、p_off),支撑表 3–表 6 与 7.4 节各图。results/eval/val/val_pipeline_views.csv—— 13,520 个验证视角,阈值选择的唯一输入(7.5 节)。results/stage1_a192/history.json、results/stage1_b224/history.json、results/stage2_resolver4/history.json—— 三个训练过程的逐轮记录,config记录配方、effective记录实际生效的超参。results/benchmarks/latency_pipeline.json—— 延迟轮次与参数计数,支撑表 7。results/canonical/key_numbers.json—— 全部数字的机读版本;docs/reports/METRICS.md与之一一对应。results/label_audit/rotation_audit.json、results/label_audit/summary.json—— 受控旋转审计与标签统计。results/experiment.json—— 平台、版本、种子与许可记录。- 权重:
release/compasstext-24/models/compasstext-24-b224.pt、compasstext-24-a192.pt、compasstext-24-resolver4.pt。
本报告的全部数字由 src/extract_metrics.py 从逐视角产物重算,不接受手写;图表由 src/make_report_figures.py 生成、src/build_reports.py 展开。第三方图像内容不随本报告分发。
