一、范围与术语约定
企业知识库的检索需求可以拆成几件具体的事:一份资料能不能被找全,关键内容能不能排到前面,给出的答案能不能指回原文,不同权限的人看到的内容能不能严格分开。我看到的方案大多只覆盖其中一两件。2026 年上半年我做了一套面向企业知识库的检索基座原型,把混合检索与 Agentic RAG 放在同一条链路上,为知识库搜索、引用式问答和后续的 Agent 应用提供共用的检索能力。原型在与一支做同类技术路线的团队交流后暂停扩展,工作重心转为跟进对方进展、判断协作与复用空间。本文保留其中已经验证的架构思路、实现边界与评测方法,作为后续交流与业务适配的设计基线。
Uveriq 是同期公开的一个项目。本文以它为案例做架构分析,材料来自仓库公开的代码结构、项目文档、技术白皮书、测试脚本入口与用户搜索契约。仓库地址为 github.com/somnifex/Uveriq,Apache-2.0 许可。
原型内部把检索与生成之间的校验环节称作“证据闭环”,对应公开文献里的 groundedness、attribution 与 provenance;把多路召回的合并称作“RRF 融合”,对应 hybrid retrieval 配合 rank fusion 与 score fusion。Uveriq 仓库里的 FAST / AUTO / DEEP、Pi Agent、Knowledge VFS、EvidenceResponseAssembler 同样是项目内部命名。
二、原型的总体结构
链路从业务问题进入,先检索后生成,证据不足时回到检索规划补充检索。
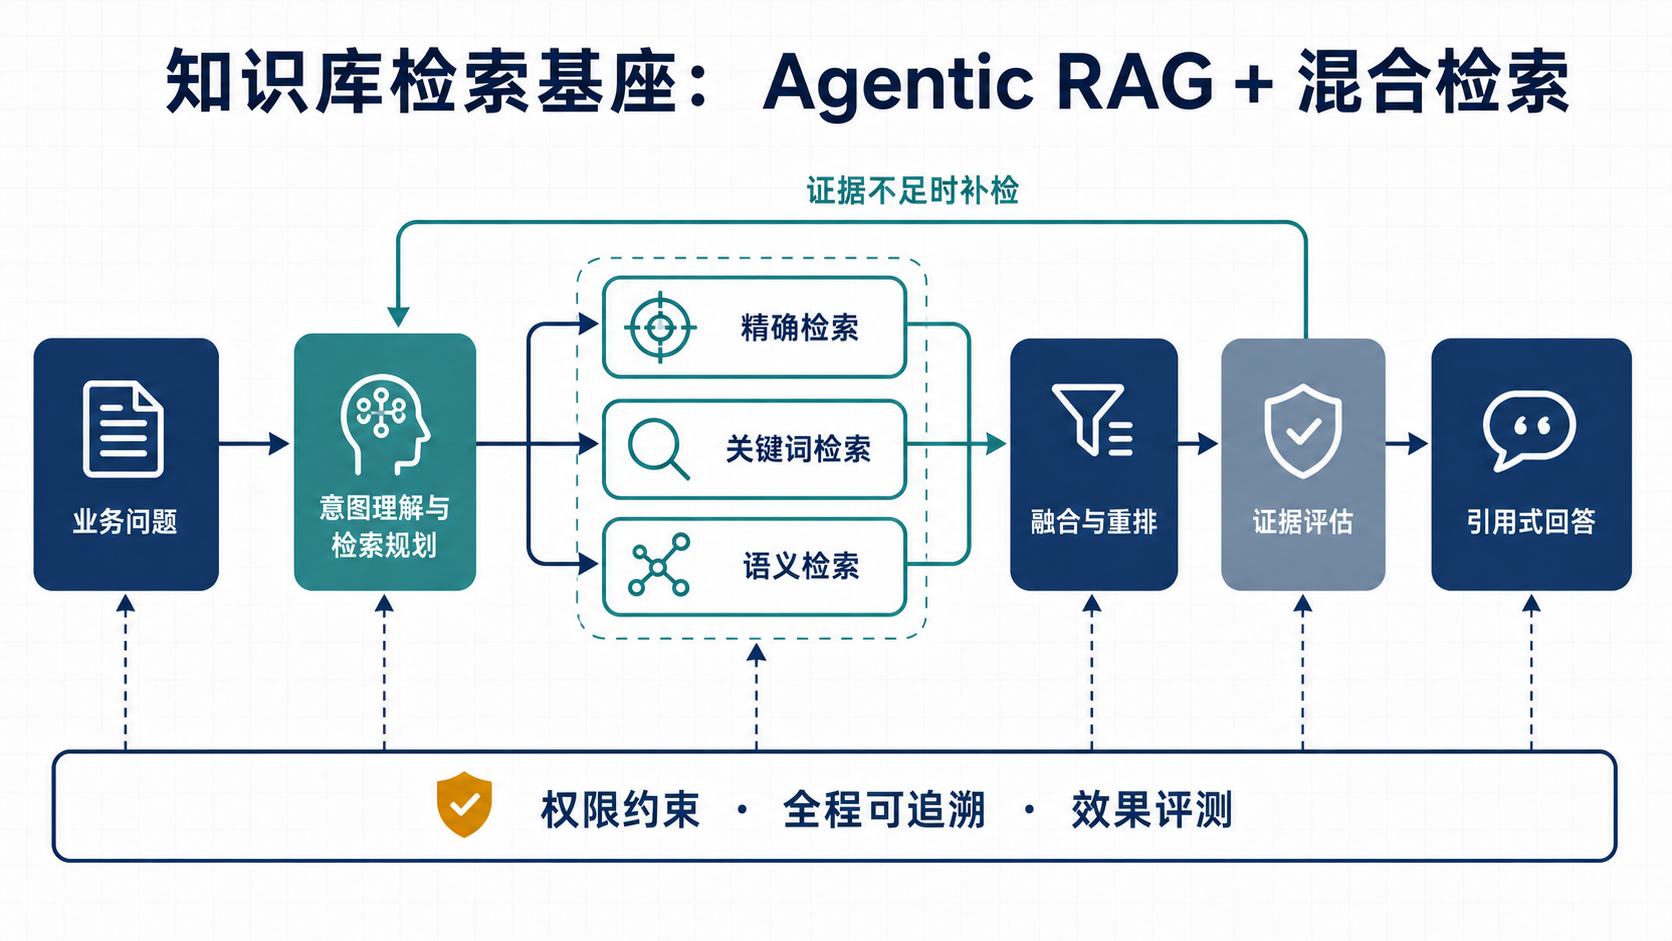
图 1 知识库检索基座的总体结构:业务问题经意图理解与检索规划后并行调用多路检索,融合重排之后评估证据,证据充分则生成引用式回答,不足则回到规划补充检索;权限约束、过程可追溯与效果评测贯穿整条链路。
组件边界按职责划分。各类 Retriever 只保留原子检索能力,规划、融合、重排与上下文扩展由独立策略承担。知识库内容、访问权限、检索索引与策略配置之间边界清晰,调整切块方式、Embedding 模型或检索参数时可以单独比较效果,不必改动整条链路。存储层保持简单分工。PostgreSQL 保存文档、权限、策略和评测元数据,对象存储保留原始文件与解析产物;OpenSearch 负责精确、关键词、向量与条件过滤检索,Redis 只用于临时状态与限流。这套划分已在原型中体现,尚未在真实集群条件下做容量与性能验证。
设计参考了 BM25 概率相关性框架、Dense Passage Retrieval、BEIR、RRF 原始论文 与 Sentence Transformers 的 Retrieve & Re-Rank 说明。公开结果用于确认方向,具体参数仍需用内部语料评测。
三、查询理解与证据校验
从问题类型到检索计划
Agentic RAG 位于查询入口和检索能力之间。它先识别问题里的设备位号、文档号、条款提示、时间范围和业务关键词,再判断问题偏精确查找、语义查找、制度条款还是 SOP 步骤,据此组合检索能力。明确的编号查询优先走精确检索,描述性问题提高语义检索权重,涉及制度和 SOP 时保留条款层级与步骤顺序,并在召回后补充必要的上下文。固定流程对所有问题使用同一套参数,是这套设计要处理的偏差来源。
公开文献对这类结构通常按 workflow 与 agent 的分界描述:workflow 走预定义路径,agent 由模型动态决定下一步,两者可以组合使用(Anthropic《Building effective agents》)。原型在检索规划环节引入模型判断,在融合、权限校验与结果组装环节保持确定性,属于两者之间的组合。2025 年的 Agentic RAG 综述(arXiv:2501.09136)把这类做法归纳为 reflection、planning、tool use 与 multi-agent 四种模式,原型对应其中的 planning 与 reflection。
证据校验与补充检索
检索完成后系统检查证据是否充足。证据偏弱时改写查询或补充检索,证据达到要求后再组织带引用的回答。
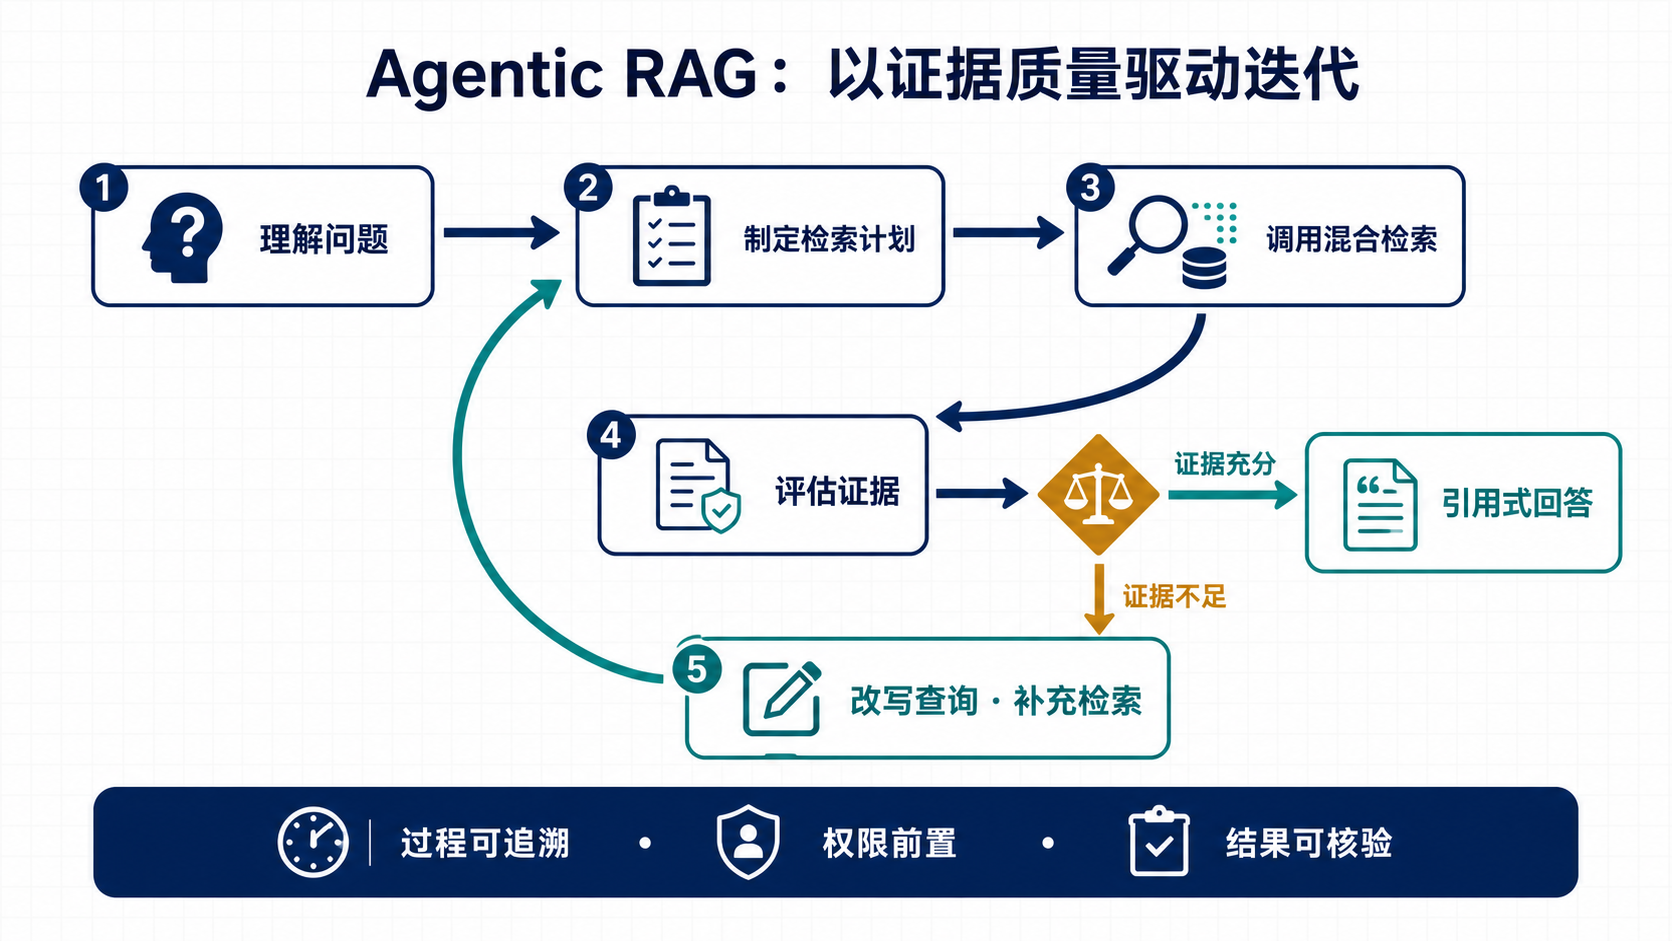
图 2 Agentic RAG 的证据闭环:理解问题、制定检索计划、调用混合检索、评估证据,证据充分时生成引用式回答,不足时改写查询并回到检索计划重新检索;过程可追溯、权限前置、结果可核验。
Self-RAG(arXiv:2310.11511)用 reflection tokens 决定是否检索,并对生成内容做自我批判;CRAG(arXiv:2401.15884)设置 retrieval evaluator 给出置信度,低置信时触发纠偏,或把查询拆解重组后重试。原型里“评估证据后改写查询”的环节与 CRAG 的触发式纠偏接近,区别在于评估信号来自规则与检索结果本身,而不是单独训练的评价模型。这个环节的收益需要在真实业务查询集上验收,原型阶段只完成了代码链路。
四、混合检索与融合机制
三路分工
混合检索由精确检索、BM25 关键词检索和 Dense 语义检索组成。设备位号、文档号、工单号、接口名和错误码更依赖精确匹配;项目名称、专业术语和条款原文适合 BM25;同义表达、口语化描述和词面差异由 Dense 检索补充。三路能力保持独立,由检索计划按问题类型并行调用。原型按调用路径区分三路,其中精确检索在语义上接近词法检索的一个受限变体,单独成路主要是为了让编号类查询有自己的过滤与计分逻辑。公开文献一般把混合检索描述为词法与向量两路,融合方式分 rank fusion 与 score fusion 两类。
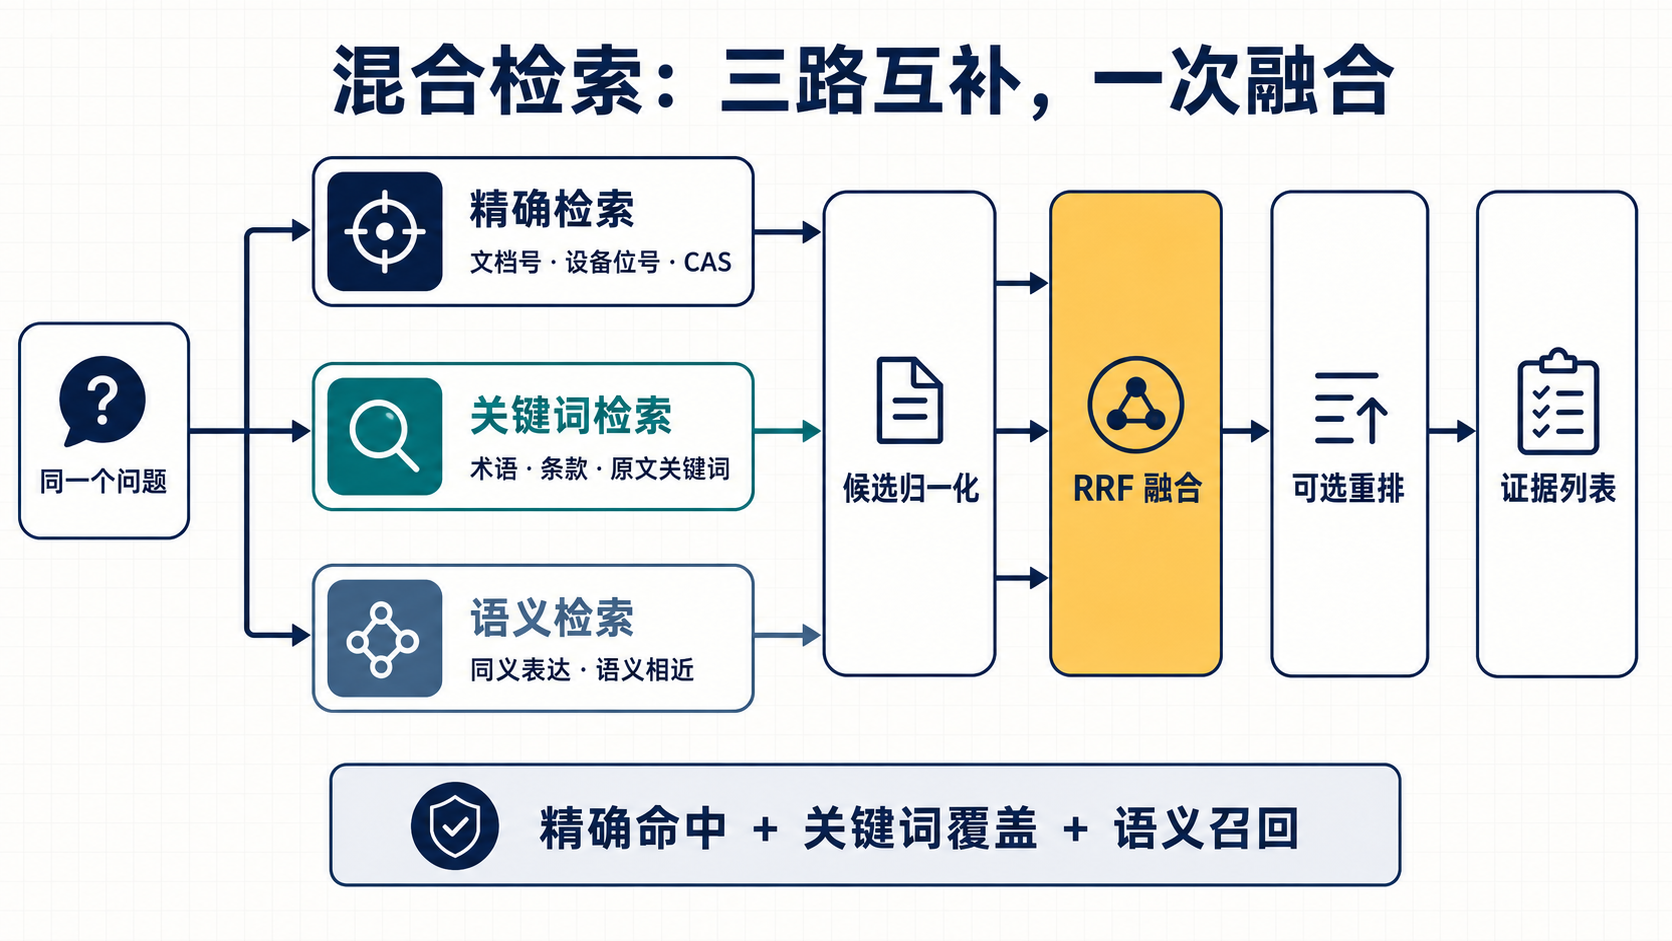
图 3 混合检索的融合机制:精确、关键词、语义三路召回经候选归一化后由 RRF 融合,可选重排之后生成证据列表,分别对应精确命中、关键词覆盖与语义召回三种能力。
RRF 与融合参数的取舍
BM25 和向量相似度的数值范围不同,原型用 RRF 按名次融合:
RRF(d) = Σ weight_i / (k + rank_i(d))
每条候选保留来自哪一路、原始排名和融合结果,便于定位召回和排序问题。
RRF 由 Cormack 等人在 SIGIR 2009 提出,论文标题即结论,称其优于 Condorcet 融合与单路 rank learning 方法(DOI: 10.1145/1571941.1572114)。Elasticsearch 官方文档把 RRF 作为内置融合方式,rank_constant 默认 60,各路等权,官方表述是使用 RRF 不需要调参(Elasticsearch 文档)。原型的公式带权重项,属于加权变体,不是官方默认的等权实现。
融合方式的选择没有单一结论。Vespa 的混合检索教程在同一数据集上给出 nDCG@10 对照:BM25 0.3210、纯语义 0.3077、混合 0.3330、hybrid-rrf 0.3233、线性归一化 0.3423,教程同时说明这些差距很小、数值会随运行波动(Vespa 文档)。在这组数据里线性归一化高于 RRF 融合。原因在于两路分数的量纲不同:BM25 无上界,向量相似度(closeness)落在 [0,1] 区间,直接加权需要先归一化或加偏置。Qdrant 的混合检索文章给出另一侧的证据:在 5 个 BEIR 式数据集上,默认 RRF 在其中 4 个胜过更强的单路检索,DBPedia 是例外;该文建议先试 RRF,再与 DBSF 比较,并指出按原始分数加权在不同查询之间不稳定,融合带来的延迟增量在 0.6 至 1.5 毫秒之间(Qdrant 文章)。Weaviate 的融合算法文章对比了两代实现:只用名次的 rankedFusion 与保留分数的 relativeScoreFusion,在 FIQA 上其内部基准报告 relativeScoreFusion 的召回比 rankedFusion 高约 6%(Weaviate 文章,内部基准为项目自报)。融合的相对收益依赖数据集与分数分布,不能预先判定哪一方更好;Qdrant 的文章提到,融合无法召回单路都没有召回的候选。
重排的收益与代价
融合后的有限候选可以交给 cross-encoder 重排,再按父文档、相邻内容或 SOP 步骤补充上下文。标准做法是两段式:bi-encoder 先召回百级候选,cross-encoder 只对这一小集逐对打分(Sentence Transformers 文档)。逐对推理的计算量使全量重排不可行,Pinecone 给出的量级是,4000 万条记录全量重排需要 50 小时以上,而向量检索在 100 毫秒以内(Pinecone 文档)。供应商通常不公布重排的公开提升数字,Cohere 的 Rerank 概览文档只说明接口与用法,没有给出指标(Cohere 文档)。原型把重排做成可选项,是否启用要等真实业务数据,延迟与模型成本这两个约束目前都还没有测。
BEIR(arXiv:2104.08663)在 18 个数据集上做零样本评测,结论之一是 BM25 是稳健的基线,重排与 late-interaction 方法平均表现最好但计算开销大,dense 单独使用时常常弱于 BM25。MTEB(arXiv:2210.07316)用于比较 embedding 模型,2022 年首版覆盖 8 类任务、58 个数据集、112 种语言,榜单在 Hugging Face 上持续更新,引用首版数字时应注意其年份。
五、权限、证据与内容组织
权限约束的位置
权限在每一路检索中生效,维度包括租户、知识库、用户或用户组、密级、有效期和文档版本。候选结果在融合、重排、扩展和生成前再次核对,发现越权或版本不一致即终止请求,相关内容不进入后续模型。当前的安全指标以 UnauthorizedRecallCount == 0 为底线。
过滤发生在检索链路的哪一步,决定了越权内容会不会进入后续的重排与生成。公开实现里这类控制通常放在查询阶段。Elasticsearch 的文档级安全(document-level security)在查询时过滤结果,官方文档同时说明评分不针对角色查询计算,并且通过聚合可能推断出被过滤文档的信息(Elasticsearch 文档)。Azure AI Search 的安全过滤器、ACL-RBAC 与敏感度标签配合也在查询时裁剪结果,官方建议在检索管道内过滤,而不是拿到结果之后再裁剪(Microsoft Learn)。Qdrant 的多租户做法是把租户作为 payload 字段分区,并强制查询携带租户过滤条件(Qdrant 文档)。原型的做法是把校验分散在每一路检索里,并在交付前复核一次,代价是每次查询都要带上完整的权限上下文。
内容分块与证据载体
证据在链路中始终保留来源、文档版本、内容位置、检索方式和权限信息。回答阶段只能使用通过校验的证据,并返回可回看的引用,业务人员据此核验结论,开发人员据此判断问题出在文档处理、召回、排序还是生成环节。对话数据可按完整会话或连续话题保存为父文档,子块保留会话、时间、参与人、话题和消息顺序;制度和 SOP 保留标题层级、条款关系和步骤顺序。检索时使用较小的内容块,进入生成阶段前再补充父级、相邻内容或 SOP 前后步骤。这样安排是为了同时满足定位精度与上下文完整:小块利于命中,大块利于成段理解。
六、评测方法
查询集与对照组
如后续恢复工程化,先准备一批来自真实对话和业务资料的查询,至少覆盖编号和专有词、同义表达、多轮上下文、时间范围、跨文档问题、歧义问题和无答案问题,每条查询标注正确文档、证据块、权限范围和答案状态。对照组为 BM25、Dense、BM25 + Dense + RRF、在融合结果上增加 Reranker。检索和生成分开看,否则最终回答的质量会掩盖召回问题。
| 观察项 | 主要指标 |
|---|---|
| 正确证据有没有进入候选集 | Recall@K、Hit Rate@K |
| 正确结果是否排在前面 | MRR、nDCG、Precision@K |
| 生成是否正确使用证据 | Context Precision/Recall、忠实度、引用正确率 |
| 权限是否可靠 | UnauthorizedRecallCount |
| 性能和成本是否可接受 | P50/P95、超时率、降级率、单次查询成本 |
指标的公开参照
TREC 2022 Deep Learning Track 用四点相关量表判定段落,其中第 1 级 Related 在评测中按不相关处理,指标为 NDCG 类,查询集基于 MS MARCO v2(TREC 数据页)。RAGAS(arXiv:2309.15217)面向检索增强生成,用 faithfulness、answer relevance 与 context relevance 做免参考答案的评估,首版只有这三个指标,context precision 与 context recall 属于后续扩展。RAGChecker(arXiv:2408.08067)把检索与生成的质量分开诊断,用于定位错误来自召回还是生成。原型的指标表把这三类都纳入。
原型的完成度
原型已完成查询理解与路由、多路召回、RRF 融合、可选重排、上下文扩展、权限检查、引用式回答和评测相关代码。自动化测试 191 项通过,4 项依赖真实基础设施的测试暂未执行,覆盖率 88.21%。测试覆盖检索和模型超时、单路降级、文档删除、权限撤销、跨租户访问、重排越权和敏感信息保护等场景。现阶段能支持的结论是架构可行、核心链路可以工作、主要安全边界有代码验证。真实 OpenSearch 集成、内部语料相关性、复杂业务问题上的补充检索收益,以及实际延迟与模型成本均未验收,因此这套成果按原型与演示系统管理,不作为生产系统的完成情况表述。
七、Uveriq:公开案例的架构分析
出处与文档状态
Uveriq 是作者的公开个人项目,仓库为 github.com/somnifex/Uveriq,Apache-2.0 许可,README 把它描述为 Agentic Knowledge Retrieval Platform,仓库内含 docs、白皮书与 ADR 的链接。按核查时的记录,该仓库创建于 2026 年 8 月,默认分支为 main,star 数为 0,PyPI 与 npm 上都没有对应发行包。另有一个同名但无关的项目 uveriqsystem/uveriq-system-website(MIT 许可,面向金融审计场景)。下文的技术描述全部来自该仓库的自述材料与公开代码结构,没有第三方复现或独立评测可引;涉及测试与指标的数字均按项目自述看待。
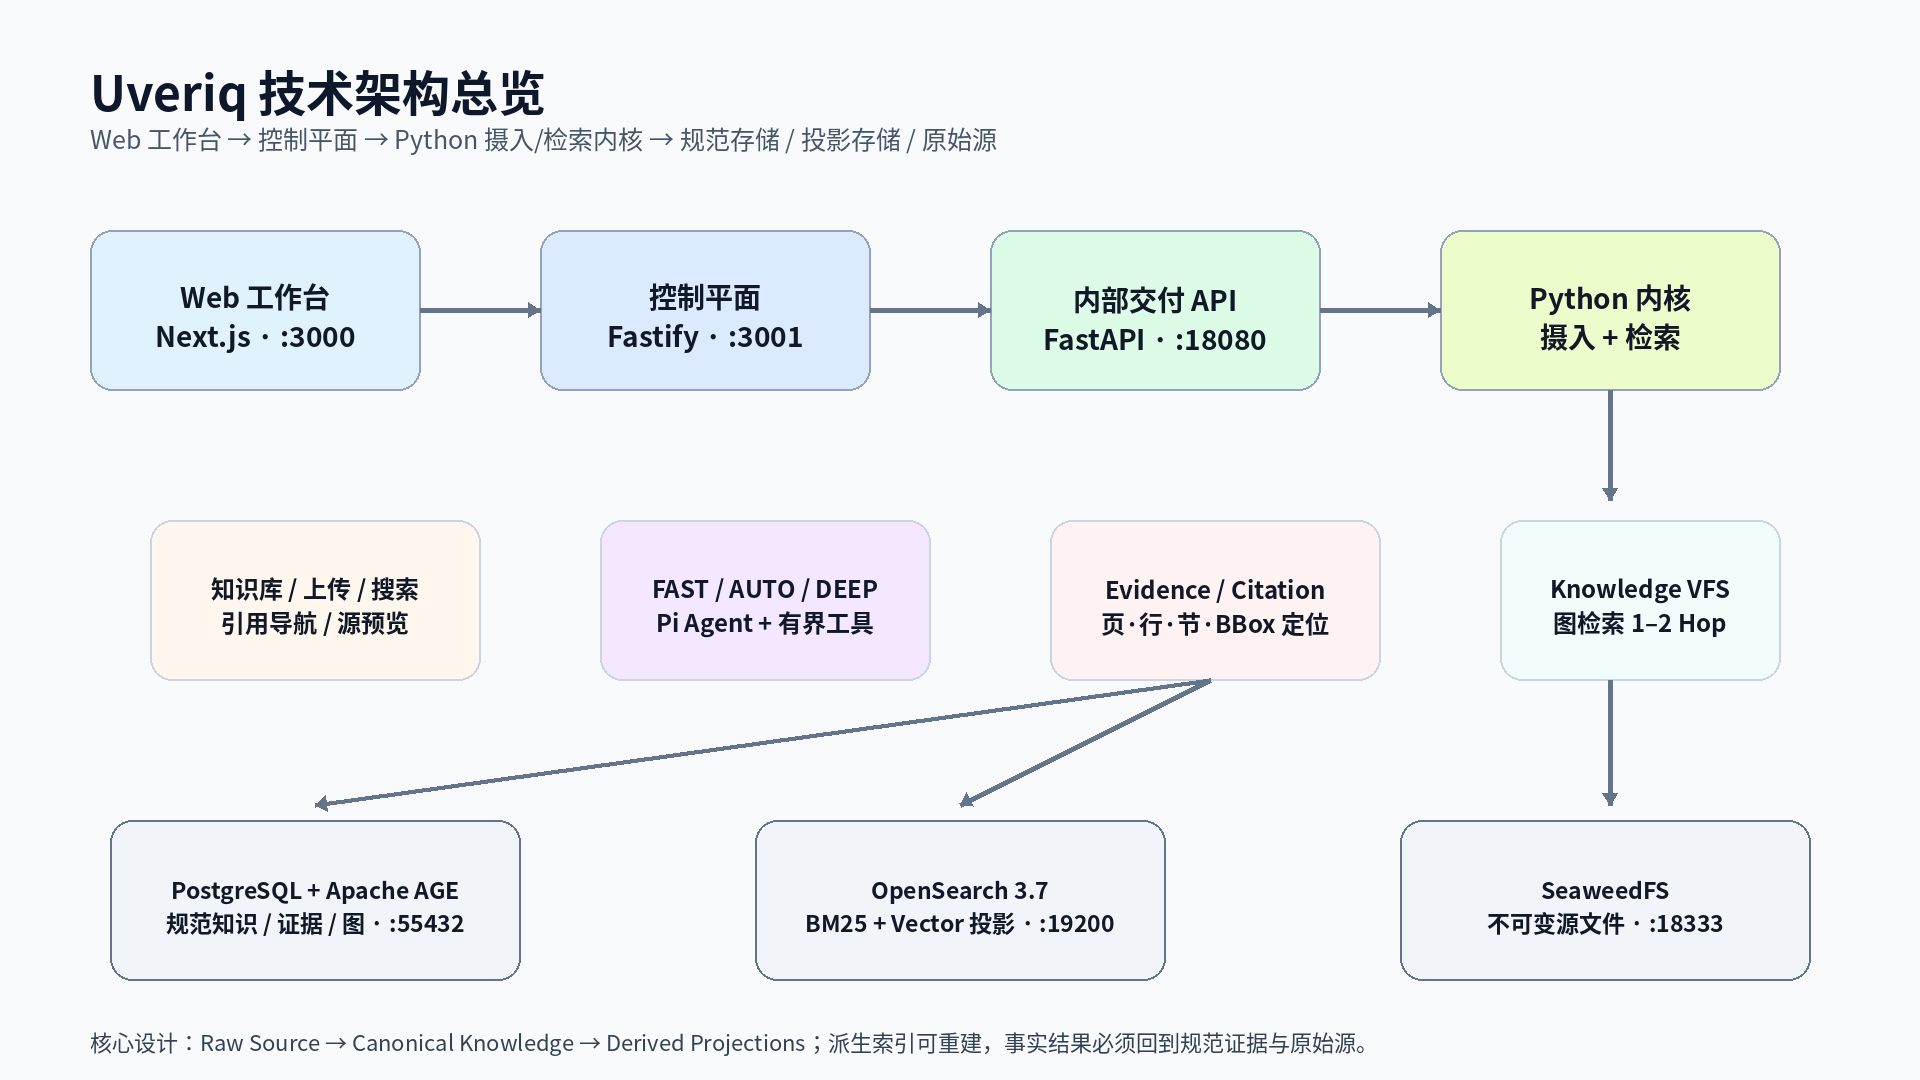
图 4 Uveriq 技术架构与核心数据流:Web 工作台(Next.js)、控制平面(Fastify)、内部交付 API(FastAPI)与 Python 摄入/检索内核依次衔接;规范知识、证据与图存于 PostgreSQL + Apache AGE,BM25 与向量投影存于 OpenSearch 3.7,不可变源文件存于 SeaweedFS。核心设计为原始源、规范知识、派生投影三层,派生索引可重建,事实结果必须回到规范证据与原始源。
分层结构与数据模型
Web 工作台由 Next.js 实现,负责知识库管理、上传、搜索、结果检查、引用导航、源预览与能力设置。控制平面基于 Fastify,职责包括认证与角色控制、限流、审计、搜索路由,以及 Agent 的运行与安全工具轨迹。Python 内核位于 src/uveriq,覆盖源保留、解析、规范化、画像、分块、索引、检索、证据、图与模型适配。共享契约包 packages/contracts 管理 TypeScript API 契约的版本,保证 SearchResponse 等公共 schema 的稳定。存储侧由 PostgreSQL 与 Apache AGE 承载规范知识与图,OpenSearch 3.7 承担 BM25 与向量检索投影,SeaweedFS 以 S3 兼容方式保存不可变源文件。
Raw Source 层包括 Document、DocumentVersion、SourceFile 三类实体,源文件不可变保留,以 SHA-256 作为版本与去重身份。Canonical Knowledge 层由 CanonicalDocument、DocumentNode 与 Evidence 组成,是规范知识的表示,保留页、行、节、偏移与 BBox 等溯源信息。Derived Projections 层包含 IngestionProfile、ChunkProjection、Chunk、EmbeddingRecord、Entity、Relationship 与 IndexGeneration,分块、向量、词法、图等投影按版本重新生成,不改动规范层。这一分层支撑版本可复现、索引可重建、证据完整性检查与源文件回溯。多种检索投影也能并存。
文档摄入与发布
文档交付由分阶段的 DeliveryCoordinator 编排。上传的文档先保留为源文件并创建文档版本,之后依次做检测与解析、规范化、选择摄入画像与构建块投影,再写入词法向量与图索引,校验后发布。格式覆盖 TXT、Markdown、PDF、DOCX、PPTX、HTML;解析层提供 PlainTextParser、MarkdownParser 与 DoclingParser,PDF 解析可以保留单元格包围盒溯源。源保留通过 S3ObjectStore.put_immutable 实现,写入与读出都校验 SHA-256。任务状态含 queued、running、retryable、failed、succeeded,并记录尝试次数、租约与处理器版本。发布通过发布清单与修订指针原子更新,使当前可搜索的代次具备明确身份。
分块由版本化的 IngestionProfile 驱动,不是固定实现。默认采用结构感知策略,以 320 token 为上限,另支持固定 token 与父子投影。StructureAwareChunker 尊重文档结构,降低跨段截断,适合政策、报告与说明书。FixedTokenChunker 采用稳定窗口与 overlap,行为确定,便于基准与回归测试。ParentChildChunker 以叶子块配合父上下文块,兼顾小块定位的高召回与较完整的上下文。
检索、路由与受控 Agent
Uveriq 把候选发现与事实证据分开:Finder 负责发现候选位置,Reader 回到规范内容,Evidence 提供可引用的事实支撑。向量相似度、BM25 分数或图置信度不直接当作事实。BM25 在 OpenSearch 上做多字段匹配与标题加权,并按租户、知识库、代次与块类型过滤,提供确定性的词法召回。向量检索由 EmbeddingProvider 实现,对维度做严格校验。多路结果以 RRF 融合,rank_constant 取 60,与 Elasticsearch 的默认取值一致。重排使用有界前缀的 RerankProvider,只对 Top-N 精排。证据读取采用批量物化,返回规范区间而不是纯 chunk 文本。
搜索开放 FAST、AUTO、DEEP 三类路由。FAST 是不经 Agent 的确定性路径;AUTO 与 DEEP 由 Pi Agent 在受控工具集合内做检索规划,再由 EvidenceResponseAssembler 依据 Agent 选定的证据确定性地组装公共响应,Agent 生成的自由文本不进入搜索响应。三档预算如下。
| 路由 | maxTurns | maxToolCalls | timeout | 累计字节预算 |
|---|---|---|---|---|
| FAST | 3 | 2 | 5 s | 128 KB |
| AUTO | 5 | 6 | 10 s | 256 KB |
| DEEP | 8 | 12 | 20 s | 512 KB |
Uveriq 把 agent 的动态决策与 deterministic workflow 的输出约束放在同一条链路里,Agent 的自由度由预算与工具白名单限制在检索策略上。Agent 可调用的工具包括 hybrid_search、evidence_read、deep_search 与 graph_search,后者执行有界的一跳或两跳关系检索并回到证据;Knowledge VFS 提供 kb_list、kb_find、kb_grep、kb_read、kb_inspect,给 Agent 一个只读的逻辑知识视图。
证据、引用与图检索
SearchResponse 的可信度来自证据链。CitationLocator 支持 page、line、section 等定位层级,可用时携带页码、BBox 与行起止。证据版本与正在组装的文档版本严格一致。
| 响应层 | 关键字段 | 作用 |
|---|---|---|
| results | document_id / version_id / title / score / citation_ids / snippet | 文档级检索结果 |
| citations | evidence_ids / source_file_id / quote / locator | 证据级可核验引用 |
| source_files | filename / media_type / byte_size / access_path | 原始源访问描述符 |
| meta | request_id / route / duration_ms / warnings / trace | 路由、性能与安全工具轨迹 |
图存储基于 Apache AGE,保存实体与 RELATED 关系,实体与关系分别通过 entity_evidence、relationship_evidence 回链规范证据。GraphSearchService 支持一到两跳检索。LLMGraphExtractor 从规范证据生成结构化图草稿,经 UUID、实体唯一性与关系引用完整性校验后写入。图检索只用来寻找关系线索,知识图与引用体系因此保持一致。
测试、部署与业务闭环
仓库的测试体系按能力拆分。根 package.json 提供 Node 测试、三个集成检查入口与统一 typecheck,Python 侧用 pytest,scripts 目录下 21 个 test-* 专题脚本覆盖从基础设施到检索质量的关键路径。按项目自述,各域的入口与覆盖重点如下。
| 测试域 | 代表入口 | 覆盖重点 |
|---|---|---|
| 摄入与解析 | test-source-retention / test-canonicalization / test-docling-formats / test-document-delivery | 源文件、格式解析、交付编排 |
| 分块与发布 | test-fixed-token-projection / test-parent-child-preview / test-structure-profiles / test-publication | 投影、画像、发布 |
| 检索 | test-bm25 / test-vector-hybrid / test-search-delivery | 词法、向量融合、搜索交付 |
| 证据与图 | test-evidence-citations / test-graph-retrieval | 引用完整性、图检索 |
| 平台与 API | test-knowledge-api / test-knowledge-vfs / test-infra / test-migrations / test-platform-health | API、VFS、基础设施、迁移、健康检查 |
| 质量评估 | test-evaluation / test-live-providers | 黄金集指标、提供方检查 |
评估指标包括 document_recall、citation_coverage、citation_correctness、required_terms_found、p50/p95 延迟与 tool_budget_compliance,把文档召回、引用完整性与正确性、Agent 预算遵守放进同一道质量门。
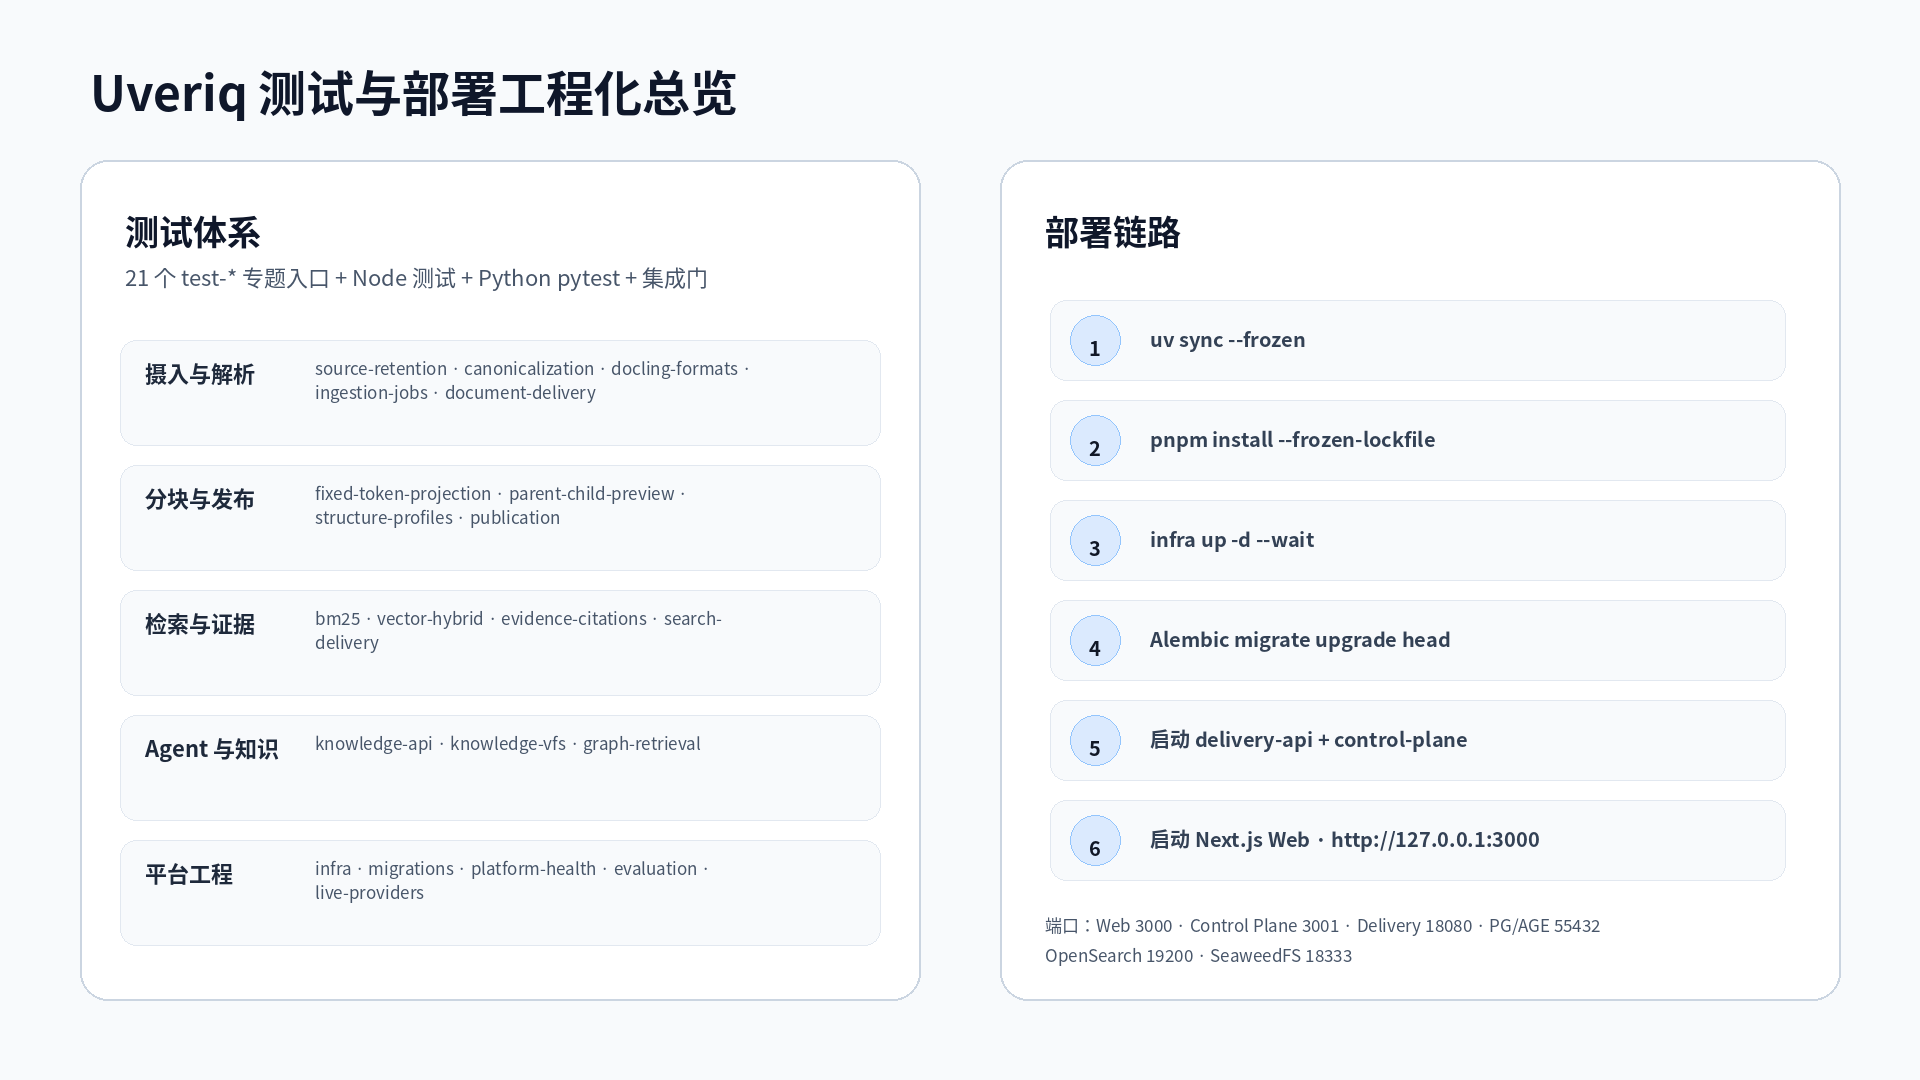
图 5 Uveriq 的测试与部署链路:左侧为按能力分类的测试入口,右侧为本地启动顺序;端口分配为 Web 3000、控制平面 3001、交付 API 18080、PostgreSQL 与 AGE 55432、OpenSearch 19200、SeaweedFS 18333。
开发部署用仓库本地 Python/Node 依赖,配合 WSL Docker Compose。核心组件的端口如下。
| 服务 | 技术 | 端口 |
|---|---|---|
| Web 工作台 | Next.js | 3000 |
| 控制平面 | Fastify | 3001 |
| 内部交付 API | FastAPI | 18080 |
| 规范与图存储 | PostgreSQL + Apache AGE | 55432 |
| 检索投影 | OpenSearch 3.7 | 19200 |
| 对象存储 | SeaweedFS | 18333 |
1 | uv sync --frozen |
浏览器经 127.0.0.1:3000 进入工作台,Web 通过同源代理把工作台密钥转换为 Bearer 头转发给控制平面。
业务侧的功能链路从创建租户范围的知识库开始,上传文档并保留原始源、创建文档版本。系统随后完成解析、规范化、分块与检索投影构建。用户选择搜索深度并提问,得到文档级结果、证据级引用与源文件描述符。点击引用可以跳到页、行、节或 BBox 位置,必要时下载原文件。
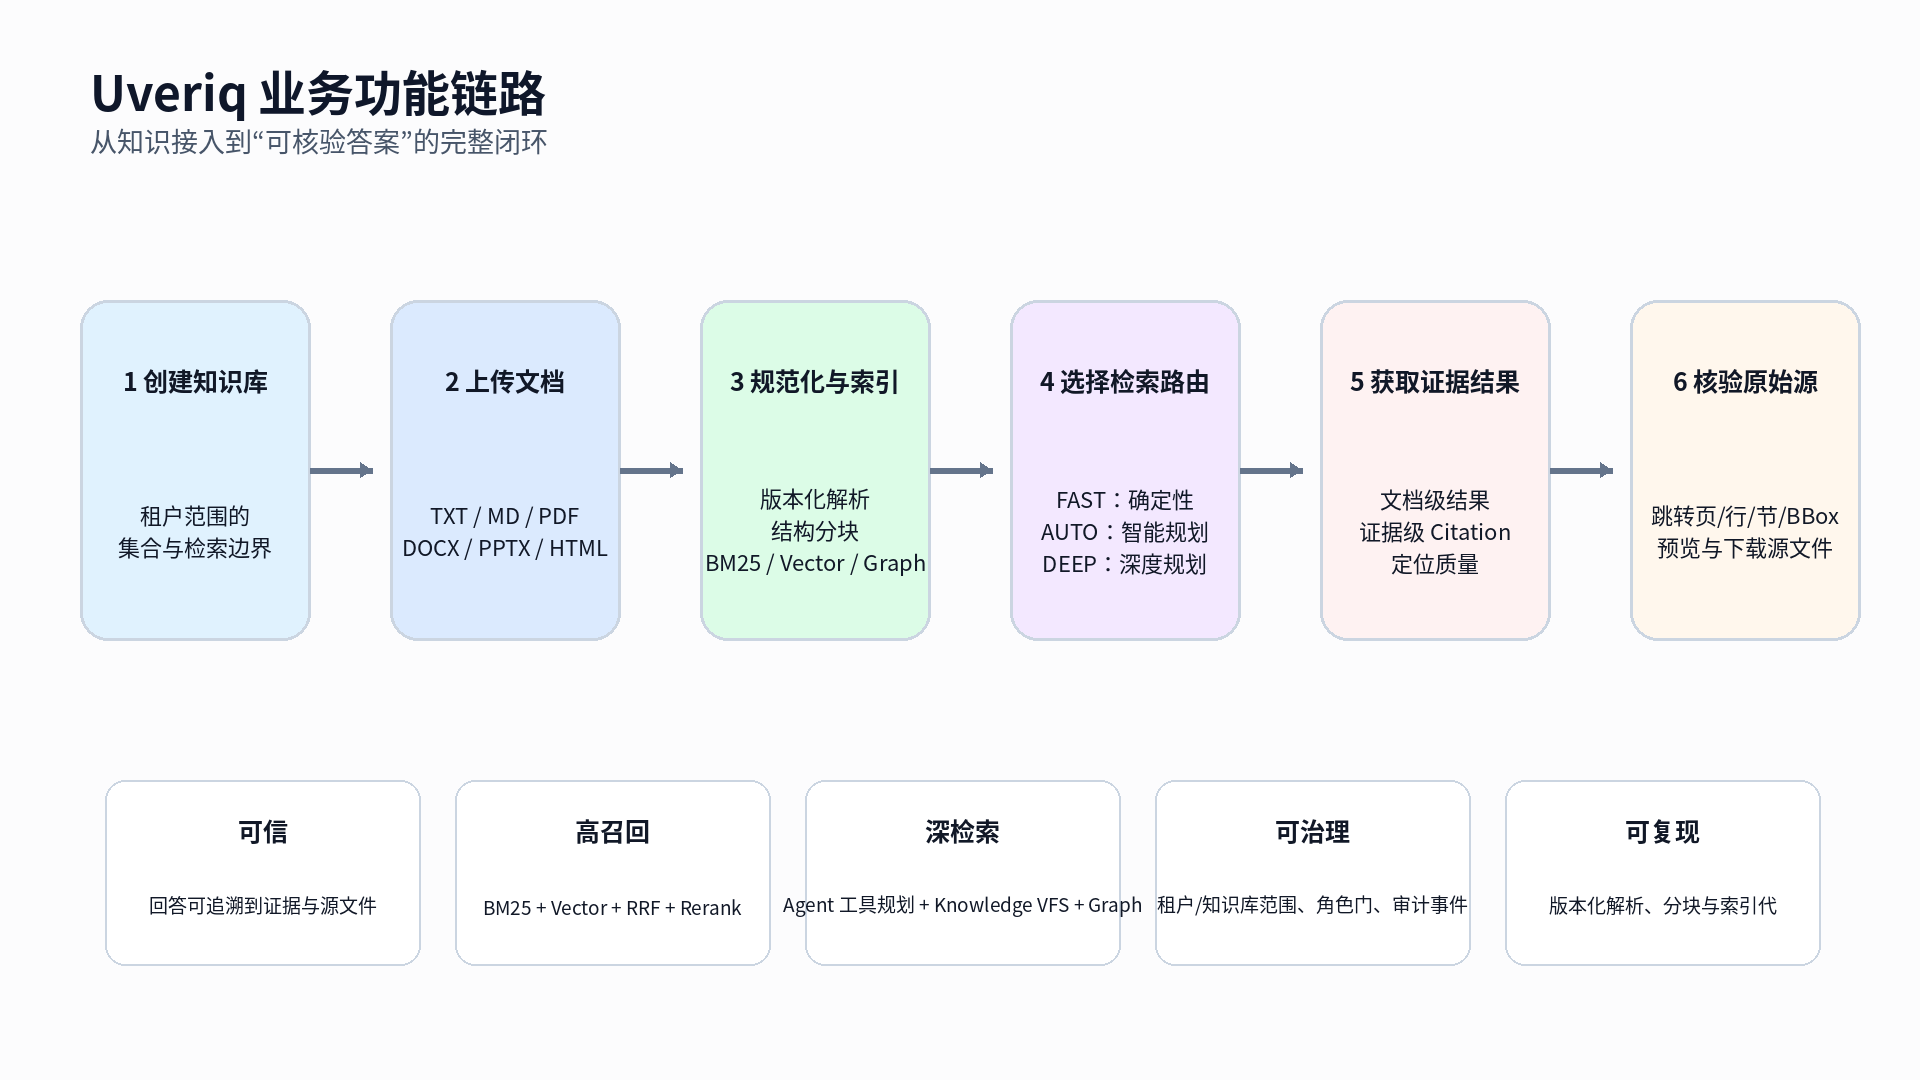
图 6 从知识接入到可核验答案的业务闭环:创建知识库、上传文档、规范化与索引、选择检索路由、获取证据结果、核验原始源六个步骤;对应可信、高召回、深检索、可治理与可复现五项能力。
项目自述的产品定位是可核验证据型的智能检索,主要对象为企业文档、政策制度、研究资料、技术文档、合同与合规材料。FAST 面向高频、稳定的事实查找与定位。需要组合检索的自然语言问题交给 AUTO,由系统自动选择混合检索、证据读取、VFS 与图工具。DEEP 面向跨文档实体关系、前因后果与多跳依据的梳理。本文未做独立验证。
八、两套系统的对照
两者都用 RRF 融合多路召回,rank_constant 都取 60,与 Elasticsearch 的默认值相同。权限过滤都放在检索链路内部,而不是拿到结果之后再裁剪。来源版本、内容位置与检索方式都保留,回答只用通过校验的证据。两者都对重排范围做有界限制,原型把它做成可选开关,Uveriq 用有界前缀的 RerankProvider 控制开销。
检索策略的组织方式不同:原型把规划、融合与重排做成独立策略,与 Retriever 解耦,改动面小、行为可预测;Uveriq 把一部分规划交给受控 Agent 并配预算,能处理更复杂的查询,代价是延迟上升、行为可预测性下降,因此它按三档路由区分场景。版本管理上,Uveriq 把内容分成原始源、规范知识与派生投影三层,索引可以按版本重建;原型的版本管理停留在文档版本与索引配置层面,没有做到投影级重生成。引用粒度上,原型的引用到块与文档版本为止,Uveriq 的引用带页、行、节与 BBox,并把文档级结果、证据级引用与源文件描述符分成三层返回。引用粒度细化会同时抬高解析、存储与契约维护成本。
九、边界与适用条件
两套系统共同的边界来自融合机制本身。融合只在各路都召回了相关候选时改善排序,单路都没有召回的内容,融合也无法纳入排序(Qdrant 文章)。RRF 与线性归一化各有胜负,Vespa 的对照里线性归一化更高,Qdrant 的对照里 RRF 在多数数据集上更好,DBPedia 是例外;选择依据应当是自家语料上的对照结果,而不是默认参数本身。重排会同时增加延迟与模型成本,两段式结构已经把重排范围压到百级候选,是否启用仍要看业务能接受的响应时间。
查询时过滤是各家的通行做法,Elasticsearch 的文档级安全不把角色查询计入评分,聚合结果可能泄漏被过滤文档的信息。权限校验需要在检索路径上生效,统计与聚合这类旁路接口同样要覆盖。原型把校验分散在每一路检索并在交付前复核,Uveriq 用租户、知识库、代次与块类型四层过滤,两者都还没有在真实的多租户压力下验证过。
评测方面,公开榜单与内部语料之间存在差距。BEIR 与 MTEB 的结果用于选型参考,MTEB 首版的 8 类任务、58 个数据集、112 种语言是 2022 年的数字,榜单本身持续更新;RAGAS 与 RAGChecker 提供的是评测框架,指标值仍取决于自建的查询集与标注质量。原型给出了四组对照与指标清单,但 191 项测试、覆盖率 88.21% 只证明链路与安全边界有代码支撑,真实 OpenSearch 集成、内部语料相关性、补充检索的收益与实际成本都尚未验证。Uveriq 的测试入口、评估指标与三档预算同为项目自述,公开仓库创建于 2026 年 8 月,尚无第三方评测和发行版本可引,PyPI 与 npm 上均未查到对应包。
组织需要有带版本管理的文档源和成文的权限模型,否则证据链与权限校验都无处落地;查询类型应当是混合的,编号类查询与描述性查询长期共存时,混合检索与路由的价值才能体现;需要先准备一批可标注的查询集,至少覆盖编号与专有词、同义表达、多轮上下文、时间范围、跨文档问题、歧义问题和不作答的情况,否则四组对照无法执行;对 Agent 路由的场景,还要接受单次查询从确定性路径的数秒级延长到十秒以上,并为此设置好降级策略。这些条件不满足时,单路 BM25 加人工翻检往往比一条没有评测的检索链路更可靠。
参考资料
- Cormack, Clarke, Buettcher. Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods. SIGIR 2009. https://dl.acm.org/doi/10.1145/1571941.1572114
- Elasticsearch 官方文档:Reciprocal rank fusion。https://www.elastic.co/guide/en/elasticsearch/reference/current/rrf.html
- Elasticsearch 官方文档:Document-level security。https://www.elastic.co/guide/en/elasticsearch/reference/current/document-level-security.html
- Vespa 文档:Hybrid Search 教程。https://docs.vespa.ai/en/learn/tutorials/hybrid-search.html
- Qdrant:Hybrid Search 文章。https://qdrant.tech/articles/hybrid-search/
- Qdrant 文档:Multitenancy with payload partitions。https://qdrant.tech/documentation/guides/multiple-partitions/
- Weaviate:Hybrid Search Fusion Algorithms。https://weaviate.io/blog/hybrid-search-fusion-algorithms
- Pinecone:Rerankers and Two-Stage Retrieval。https://www.pinecone.io/learn/series/rag/rerankers/
- Sentence Transformers 文档:Retrieve & Re-Rank。https://sbert.net/examples/sentence_transformer/applications/retrieve_rerank/README.html
- Cohere 文档:Rerank 概览。https://docs.cohere.com/docs/rerank-overview
- Thakur 等. BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models. arXiv:2104.08663。https://arxiv.org/abs/2104.08663
- Muennighoff 等. MTEB: Massive Text Embedding Benchmark. arXiv:2210.07316。https://arxiv.org/abs/2210.07316
- MTEB 榜单。https://huggingface.co/spaces/mteb/leaderboard
- Es 等. RAGAS: Automated Evaluation of Retrieval Augmented Generation. arXiv:2309.15217。https://arxiv.org/abs/2309.15217
- Ru 等. RAGChecker: A Fine-grained Framework for Diagnosing Retrieval-Augmented Generation. arXiv:2408.08067。https://arxiv.org/abs/2408.08067
- TREC 2022 Deep Learning Track 数据页。https://trec.nist.gov/data/deep2022.html
- Singh 等. Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG. arXiv:2501.09136。https://arxiv.org/abs/2501.09136
- Asai 等. Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection. arXiv:2310.11511。https://arxiv.org/abs/2310.11511
- Yan 等. Corrective Retrieval Augmented Generation. arXiv:2401.15884。https://arxiv.org/abs/2401.15884
- Anthropic:Building effective agents。https://anthropic.com/engineering/building-effective-agents
- Microsoft Learn:Document-level access control in Azure AI Search。https://learn.microsoft.com/en-us/azure/search/search-document-level-access-overview
- Uveriq 仓库(Apache-2.0)。https://github.com/somnifex/Uveriq
